Google Discover trie le périmé avant de classer : le papier SDF face à nos données
Depuis deux ans, Google Discover retire les articles périmés avant même de les classer, et les signalements de contenu périmé ont baissé de 54,9 % sur la période. Deux modèles font ce tri : le premier repère l'article qu'une actualité plus récente a rendu caduc, le second estime quand un article a déjà reçu l'essentiel de son trafic. Six chercheurs de Google décrivent ce système, SDF, dans un papier présenté à la conférence CIKM 2026, que nous avons confronté à nos propres données Discover. SDF tournait déjà en début d'année et explique donc mal, à lui seul, la baisse de portée que notre journal de bord relève depuis juillet. Il en éclaire la forme : les articles gardent leur meilleur jour et perdent leur fin de vie.
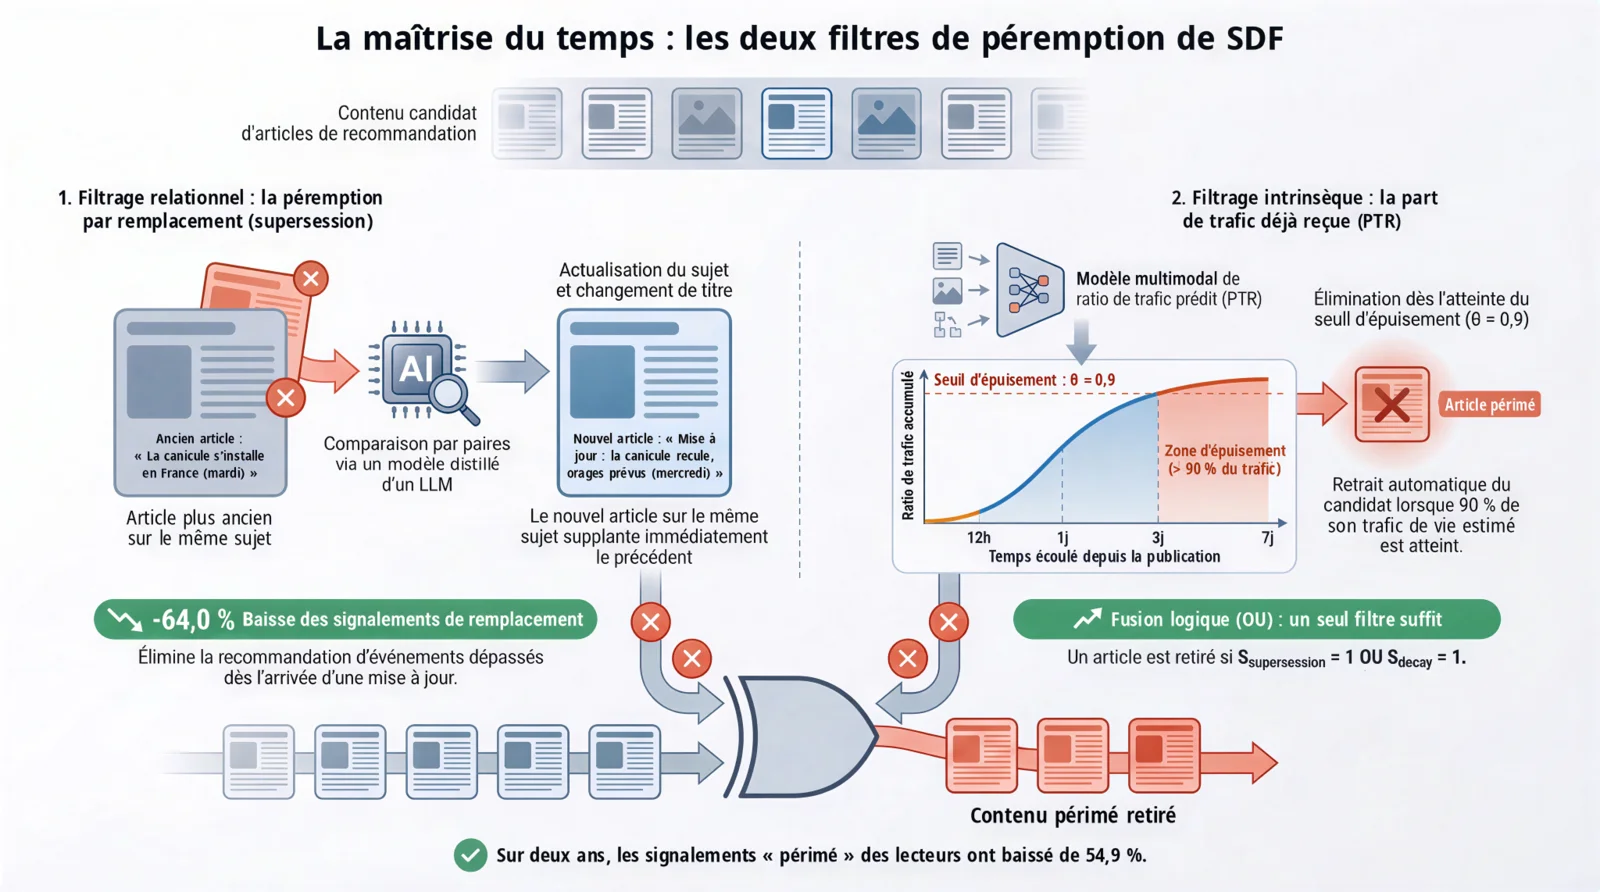
La maîtrise du temps, résumé visuel du papier. À gauche, le filtre de supersession : un modèle compare l'article de mardi (« La canicule s'installe en France ») à celui de mercredi (« La canicule recule, orages prévus ») et retire le premier. À droite, le filtre de décroissance : un modèle multimodal prédit la part du trafic de vie déjà reçue et retire l'article quand elle atteint 90 %. Le modèle travaille sur sept horizons, de 12 heures à 14 jours ; l'image en montre quatre. Les deux décisions sont réunies par un OU : un seul filtre suffit pour écarter l'article, et seuls les articles restants passent au classement. L'image parle de filtrage « relationnel » et « intrinsèque » : ce sont la supersession et la décroissance de l'article, et son « seuil d'épuisement » est le seuil θ. L'exemple de la canicule est de nous, le papier en donne d'autres.
Une carte « match décisif ce soir » trois jours après le match
Un fil d'actualité qui annonce « Match décisif ce soir » trois jours après le coup de sifflet final : la scène est banale. Selon les auteurs du papier, ce type de recommandation périmée est l'une des premières causes de plainte sur les grandes plateformes de contenu.
Pour l'éviter, on s'appuie d'ordinaire sur deux garde-fous simples. Le premier est une coupure d'âge fixe, du type « rien au-delà de 48 heures ». Elle retire aussi les guides intemporels, qui restent utiles bien plus longtemps. Le second est un seuil de clics : on retire l'article quand ses clics s'effondrent. Pour le constater, il faut d'abord l'avoir montré, parfois à des milliers de lecteurs. Le papier qualifie ces deux recettes d'approximations grossières :
« Traditional countermeasures serve as crude proxies: age cutoffs poorly reflect actual relevance loss, while engagement heuristics rely on lagging signals, broadly exposing users to stale content before the system adapts. »
SDF, pour Supersession-Decay Filtering, part d'une autre idée : un article se périme de deux façons. Il peut être remplacé par une information plus récente (la supersession1). Il peut aussi s'user de lui-même, parce que son sujet avait une durée de vie courte (la décroissance). Le premier cas oblige à comparer deux articles entre eux. Le second se lit dans l'article seul. SDF confie donc chaque cas à un modèle distinct et retire un article dès que l'un des deux le juge périmé, avant l'étape de classement. Selon le papier, ce tri fait aussi économiser près de 8,7 % des heures de calcul du service.
Le papier SDF en détail
Le papier s'intitule « Decomposing Staleness in Recommender Systems: A Dual-Filter Framework for Supersession and Decay ». Ses six auteurs travaillent chez Google : Di Bai, Feng Han, Zhenwei Tang, Jintao Liu, Luoshu Wang et Jialu Liu. Mis en ligne sur arXiv le 16 août 2026, il sera présenté à CIKM 2026, à Rome, du 7 au 11 novembre. Le terrain d'application est explicite : SDF y est décrit comme « fully deployed in Google Discover », un fil qui compte selon le texte des centaines de millions d'utilisateurs actifs par jour et des milliards par mois. Les résultats portent sur deux ans de production. La date de parution suit le calendrier de la conférence et ne signale aucun lancement. La mesure la plus récente du papier date du premier trimestre 2026 ; ce qui a pu changer depuis reste inconnu.
Les auteurs illustrent les deux mécanismes par des exemples tirés de l'actualité. Pour la supersession, un bulletin indiquant que la reine Elizabeth II est « sous surveillance médicale », rendu caduc en quelques heures par l'annonce de sa mort, ou un article disant que Shohei Ohtani « étudie les offres de plusieurs équipes », périmé dès l'annonce de sa signature avec les Dodgers. Pour la décroissance, un guide pour observer « la pluie d'étoiles filantes de ce soir », très utile un soir puis presque plus du tout, ou une vidéo locale attendrissante qui s'efface d'elle-même, sans aucune suite.
Le premier filtre retire l'article qu'un article plus récent a remplacé
Ce filtre compare deux articles. Un article devient périmé quand un article plus récent, sur le même sujet, contredit, dépasse ou remplace ce qu'il disait. Son âge seul ne suffit pas. Le papier définit le « même sujet » comme le même événement ou la même entité2. Et seul un article plus récent peut en rendre un autre obsolète.
Le tableau 2 du papier montre deux décisions du modèle, avec le raisonnement qu'il rédige. Dans la première, un article annonce que les Oakland Athletics veulent prolonger leur série de victoires face aux Texas Rangers. L'article suivant rapporte que les Rangers ont remporté la série. Le modèle écrit que le second « rapporte l'issue de cette série, ce qui rend le premier article dépassé » et conclut : périmé. Dans la seconde, un article traite du « mur des taux fixes » qui menace le marché immobilier australien. Un article plus récent présente un rapport général de CoreLogic, une société de données immobilières, sur l'évolution du marché depuis trois ans. Les deux parlent d'immobilier australien, mais seul le premier traite des taux fixes. Le modèle conclut : frais. L'article précis garde une information absente du plus récent.
En production, le papier cite deux autres réussites : « House GOP leaders float new plan », jugé périmé par « House Republicans failed to agree on a spending plan », et « Mazda 3 IPM launching soon? », jugé périmé par « Mazda 3 prices revealed ».
Pour entraîner ce juge, il faut des paires d'articles étiquetées, en très grand nombre. Les auteurs les font produire par un grand modèle de langage, PaLM 2-L. Ils ont d'abord étiqueté 300 paires à la main, puis ajusté la consigne jusqu'à ce que PaLM 2-L dépasse 90 % de précision et de rappel3 sur ces paires. PaLM 2-L tire ensuite sept réponses indépendantes par paire et retient la majorité, sur le verdict puis sur l'explication. Le corpus final compte 1 100 133 paires. Le choix des paires compte autant que leur étiquetage : deux articles trop proches sont des doublons, deux articles trop éloignés parlent d'autre chose. Les cas utiles se trouvent entre les deux : des articles assez proches pour traiter du même sujet, assez différents pour apporter du neuf.
Ce grand modèle demande trop de calcul pour juger des millions d'articles par jour. Les auteurs transfèrent donc son savoir, par distillation4, à un modèle plus petit : T5, dans sa version à 11 milliards de paramètres. Ce petit modèle écrit d'abord une courte explication, puis son verdict, sous la forme « {explication}. Therefore, {périmé ou frais} »5. Les auteurs l'entraînent aussi sur une tâche voisine, l'inférence en langue naturelle6, qui consiste à juger le rapport logique entre deux phrases.
| Variante du petit modèle | Précision | Rappel | F1 |
|---|---|---|---|
| Verdict seul | 83,68 % | 85,15 % | 84,41 % |
| Verdict seul, avec NLI | 84,25 % | 84,65 % | 84,45 % |
| Explication puis verdict | 81,31 % | 88,14 % | 84,59 % |
| Explication puis verdict, avec NLI (version déployée) | 84,31 % | 85,28 % | 84,79 % |
Tableau 1 du papier, sur 110 155 paires de test. Les écarts sont faibles ; la version déployée obtient le meilleur F1.
Sur 550 paires tirées de Discover et notées par des humains, le modèle déployé atteint 83,5 % de précision et 95 % de rappel. Il repère donc presque tous les cas de supersession, au prix d'erreurs dans l'autre sens : environ une paire sur six qu'il juge périmée est jugée fraîche par les évaluateurs.
En production, ce filtre tourne de deux façons. Au fil de l'eau, il étiquette presque en temps réel les articles sensibles au temps, à mesure qu'ils arrivent. Plus tard, un passage groupé reprend les articles peu exposés et ceux que le premier passage a manqués, puis étend l'étiquette « périmé » aux autres articles regroupés sur le même sujet.
Le second filtre retire l'article qui a déjà reçu l'essentiel de son trafic
Le second filtre regarde un article seul et estime quelle part de sa vie est déjà derrière lui. Les auteurs mesurent cette vie par le trafic : un article d'actualité reçoit la plus grande part de ses visites peu après sa publication, un article intemporel les reçoit de façon plus régulière.
Le modèle s'appelle PTR, pour predicted traffic ratio7. Pour une durée donnée après la publication, appelée horizon, il prédit la part du trafic total que l'article aura reçue à ce moment-là. Le trafic total se compte sur 30 jours, une durée qui couvre selon les auteurs la vie de la plupart des contenus de Discover. Il y a sept horizons : 12 heures, 1, 3, 5, 7, 10 et 14 jours. Ils suivent des rythmes familiers, quelques heures pour l'information de dernière minute, un à trois jours pour l'actualité du jour, cinq à sept pour un contenu hebdomadaire et jusqu'à deux semaines pour les sujets qui s'usent lentement. L'horloge démarre quand Google indexe l'article, en pratique peu après sa publication.
Le modèle lit seulement le contenu : le texte, les images et la vidéo, donnés ensemble au même modèle dès l'entrée (fusion précoce8). Une équipe éditoriale a classé un jeu d'articles selon leur sensibilité au temps. Sur ce jeu, cette méthode classe correctement 80 % des cas, contre 76 % quand texte, images et vidéo sont traités à part puis assemblés.
Le modèle apprend sur les clics venus de la recherche Google, plutôt que sur les pages vues. Les auteurs expliquent que les pages vues, plus nombreuses, sont « biased by publisher promotion », faussées par la mise en avant que l'éditeur fait de ses propres articles. Un clic de recherche traduit au contraire une intention active du lecteur.
À chaque instant, le système regarde la prédiction du dernier horizon franchi : un article publié il y a quatre jours est jugé sur sa prédiction à 3 jours. Si elle atteint le seuil θ = 0,99, l'article est retiré : le modèle estime qu'il a déjà reçu 90 % de son trafic de vie, et que le servir encore rapporterait peu. Les auteurs ont choisi ce seuil parmi 0,85, 0,9, 0,95 et 0,98, pour garder une précision élevée. Cinq personnes ont noté chaque article de test. La précision du filtre dépasse 88 %, que l'on retienne l'avis de trois évaluateurs sur cinq ou seulement les cas où les cinq sont d'accord. Son F1 monte de 78,07 % dans le premier cas à 87,50 % dans le second.
Le papier donne trois cas de production. Un guide d'observation des Géminides a été retiré après la nuit de l'événement. Un guide du festival culinaire de Phuket, qui dure plusieurs jours, a été conservé pendant toute sa période utile. Un article explicatif du New York Times sur le coaching santé a passé le filtre à chaque fois.
Un article intemporel qui reçoit ses visites de façon régulière sur trente jours a reçu, à 14 jours, environ 14/30 de son trafic, soit 0,47. Il reste loin de 0,9 à tous les horizons, et le filtre le laisse passer. Un avant-match qui reçoit 95 % de ses clics de recherche dans les 24 heures franchit le seuil dès l'horizon d'un jour. Ces deux profils sont des exemples de notre cru, construits à partir des définitions du papier.
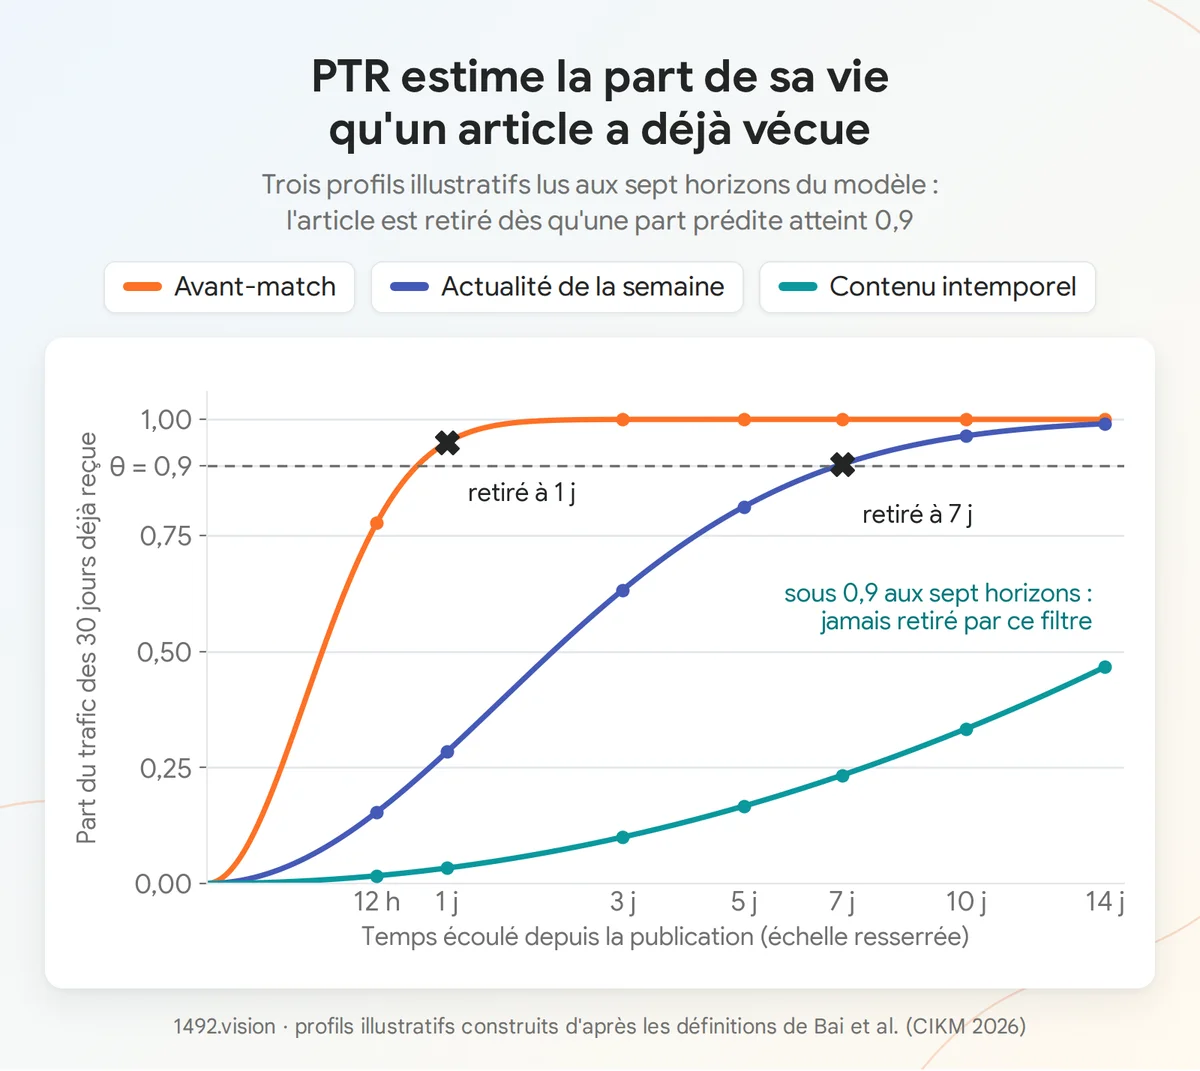
Trois profils types de part du trafic de vie reçue, selon l'âge de l'article, avec le seuil θ = 0,9 et les sept horizons du modèle. Un avant-match franchit le seuil dès le premier jour, un contenu hebdomadaire vers une semaine, un contenu intemporel reste sous le seuil jusqu'à 14 jours.
Les deux filtres sont réunis avant le classement
Les deux décisions sont réunies par un OU logique. Le papier l'écrit S = Ssupersession ∨ Sdecay : l'article est retiré si l'un ou l'autre filtre le signale. Les articles retirés sortent de la liste des candidats, ceux parmi lesquels le classement choisit les articles à servir. Le lecteur ne les verra pas.
Les deux signaux portent sur l'article et sont les mêmes pour tous les lecteurs : seul le temps les fait varier. Google les calcule à l'avance et les garde en mémoire. Quand un lecteur ouvre son fil, appliquer SDF revient à consulter une table avec l'heure du moment. Le classement qui suit repose toujours sur l'engagement et les tendances : SDF retire des candidats, le classement décide de l'ordre du fil.
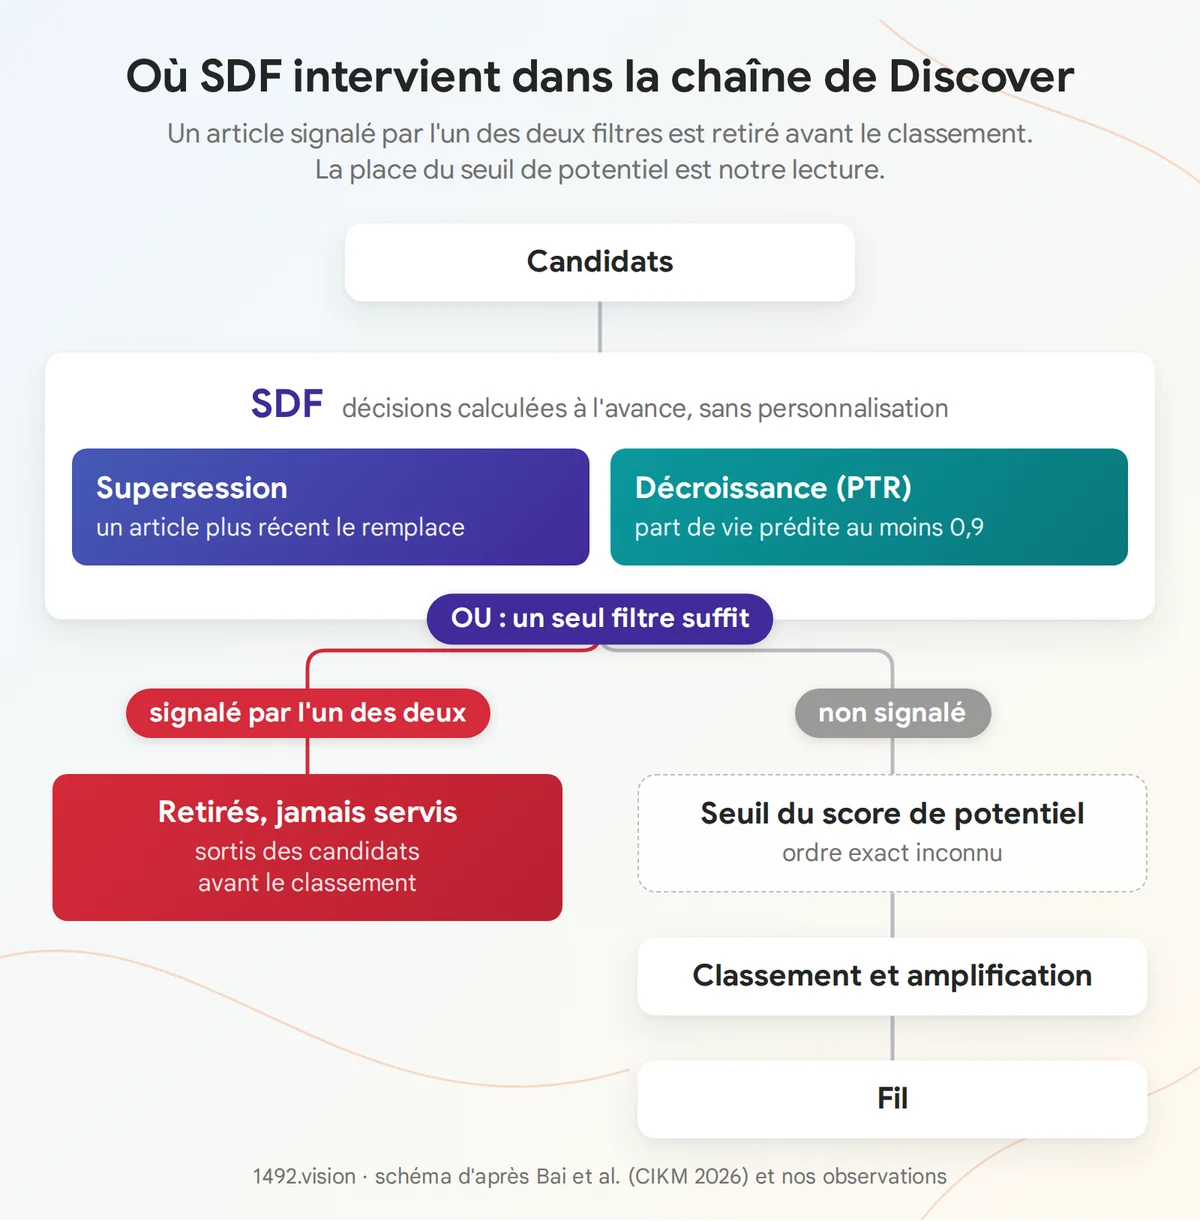
Position de SDF dans la chaîne de Discover. Les candidats passent les deux filtres, réunis par un OU ; un article retiré disparaît du fil. Les autres passent ensuite le seuil du score de potentiel de sujet, un score que nous suivons et que nous décrivons plus bas, puis le classement et l'amplification10. L'ordre exact entre SDF et ce seuil reste inconnu. Schéma : 1492.vision, d'après Bai et al. (2026) et nos observations.
SDF fait baisser les signalements de contenu périmé de 54,9 %
Les tests en ligne posaient un problème de mesure : les signalements des lecteurs sont trop rares pour départager deux variantes. Les auteurs ont donc fait noter par des évaluateurs, chaque semaine pendant quatre semaines, deux lots d'articles : ceux que la variante testée fait monter dans le fil, et ceux qu'elle fait descendre11. L'indicateur est l'écart entre la part d'articles périmés dans le premier lot et dans le second. Plus il est négatif, mieux la variante écarte le périmé. Toutes les variantes ont été réglées pour garder l'engagement au moins stable. Le papier teste ainsi SDF, chacun de ses deux filtres seul, et une référence qui combine les deux garde-fous classiques décrits plus haut : une coupure d'âge et un seuil d'engagement.
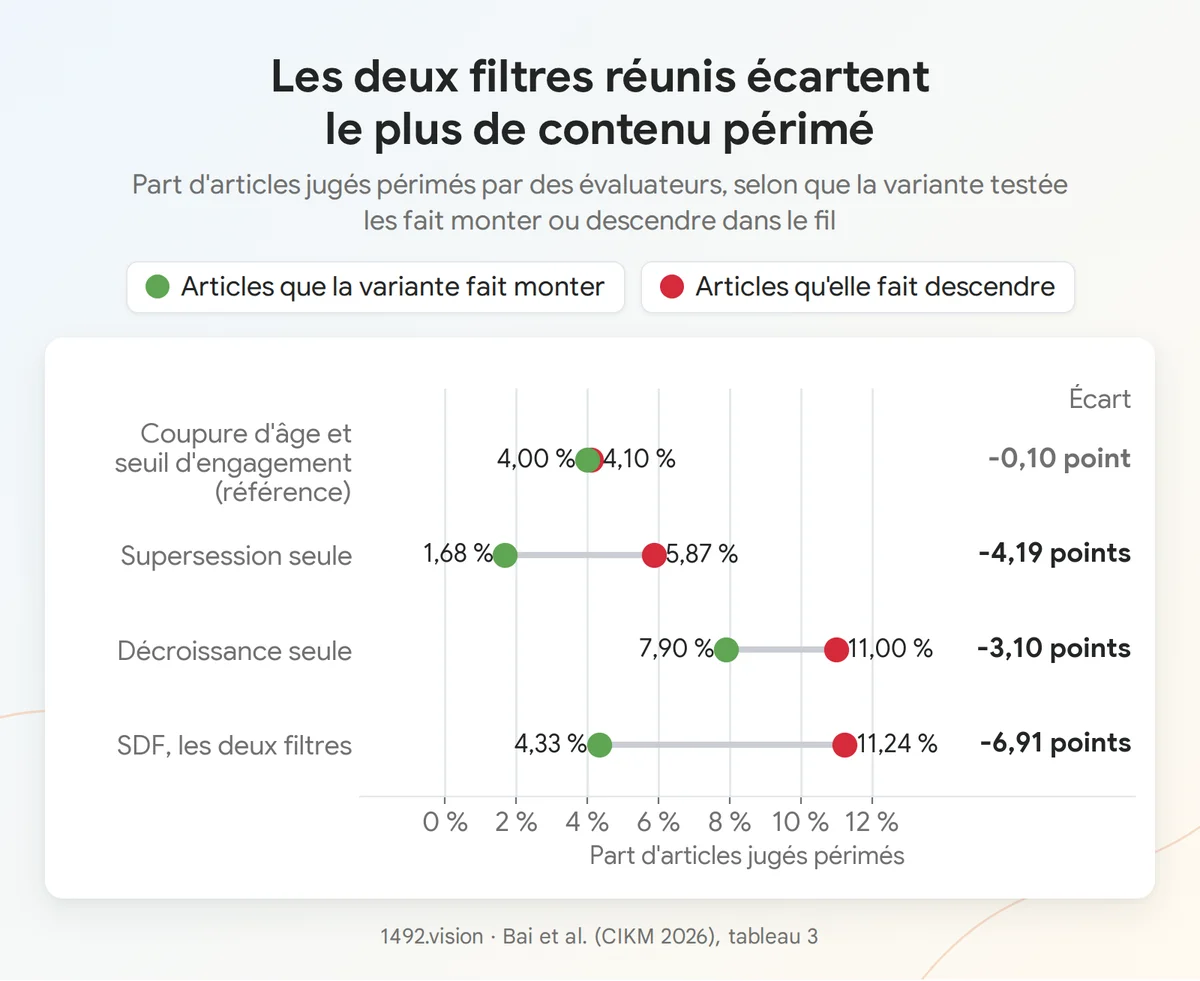
Tableau 3 du papier, redessiné. Pour chaque variante, la part d'articles jugés périmés parmi ceux qu'elle fait monter et parmi ceux qu'elle fait descendre. Marges d'erreur omises (de 0,81 à 2,56 points). Les deux points de la référence se confondent : son effet est nul à la précision de la mesure. Chaque filtre de SDF a un effet à lui seul, et les deux ensemble font le plus.
Les articles que SDF fait descendre sont périmés dans 11,24 % des cas, ceux qu'il fait monter dans 4,33 %, soit 6,91 points d'écart. Chaque filtre agit déjà seul, et les deux réunis font le plus. Les auteurs en concluent que les deux filtres visent des formes de péremption largement distinctes.
Avec la décroissance seule, les articles que la variante fait monter sont jugés périmés dans 7,90 % des cas, presque deux fois plus souvent que ceux que fait monter la référence (4,00 %), un écart que le papier ne commente pas. Chaque test déplace ses propres articles, si bien que ces taux se comparent mal d'une variante à l'autre. Les places libérées par le filtre de décroissance profitent peut-être en partie à des articles que seul l'autre filtre sait repérer, ceux qu'une actualité plus récente a dépassés. Avec les deux filtres, la part de périmés parmi les articles montés est de 4,33 %.
Un second test a duré deux mois : une partie des utilisateurs a été privée des deux filtres (groupe témoin12). Face à ce groupe, SDF fait baisser le taux de rejet des cartes de 0,16 % et fait monter la diversité du fil de 0,13 % et l'engagement positif de 0,26 %. Ces effets sont petits mais statistiquement significatifs, et ils apparaissent alors que le filtrage réduit le nombre de candidats.
Sur deux ans de production, le papier suit les signalements « périmé » que les lecteurs déposent dans le menu qualité de Discover, classés ensuite en supersession ou en décroissance. Par rapport au niveau d'avant le déploiement, le total affiche une baisse de 54,9 %, avec un recul de 64,0 % pour la supersession et de 34,4 % pour la décroissance. La période couvre, précisent les auteurs, des mises à jour successives du modèle et une extension à d'autres langues et pays, sans détail ni date.
Le filtrage réduit aussi le calcul. Au premier trimestre 2026, le filtre de supersession a économisé 4,76 % des heures de calcul du service, sur processeurs classiques et sur TPU (les puces que Google conçoit pour l'apprentissage automatique, par opposition aux CPU généralistes), et le filtre de décroissance 3,98 % de plus, soit près de 8,7 % au total. Les articles retirés échappent aux étapes de notation les plus lourdes.
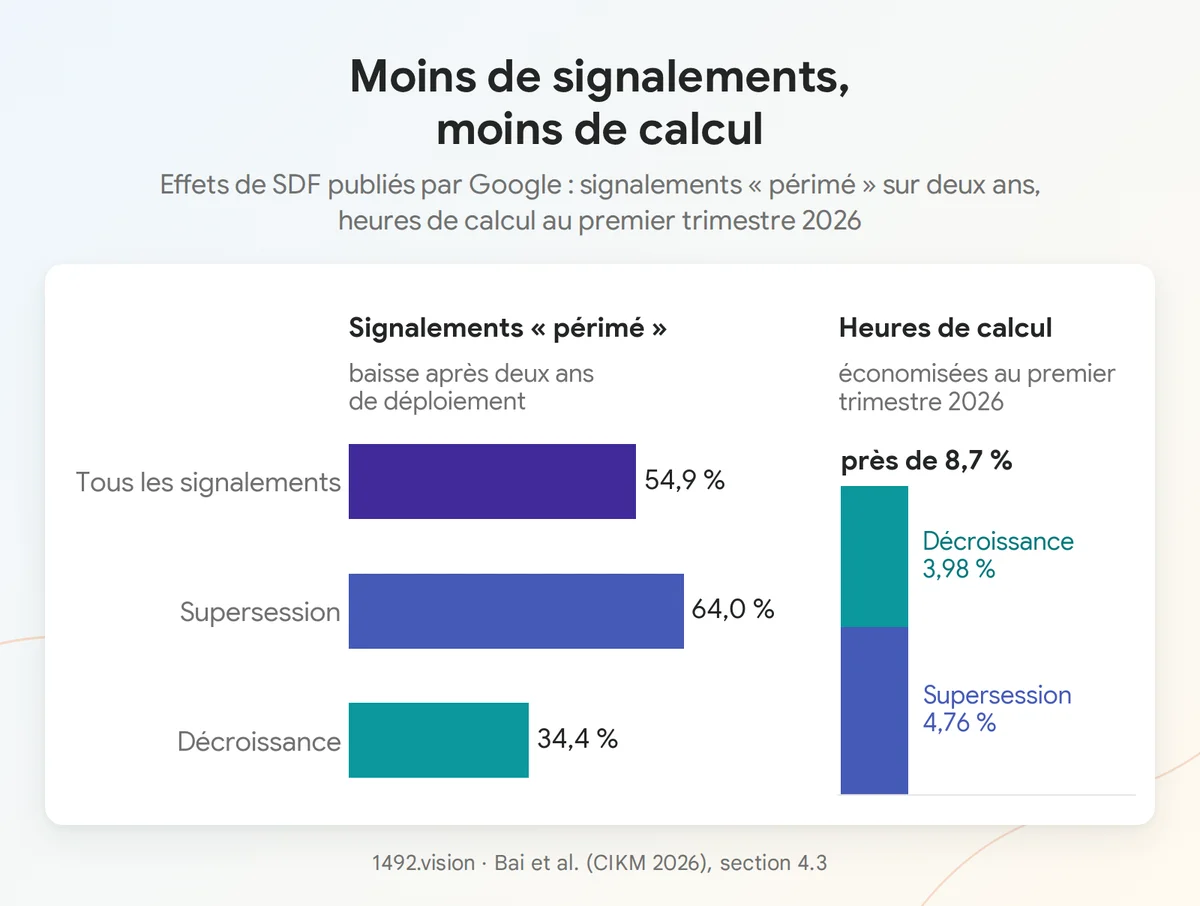
À gauche, la baisse des signalements « périmé » déposés par les lecteurs sur deux ans de déploiement, par rapport au niveau d'avant SDF. À droite, les heures de calcul économisées au premier trimestre 2026. Données : Bai et al. (2026), section 4.3.
Les auteurs reconnaissent trois échecs
Les auteurs listent trois échecs. Le filtre de supersession hésite sur certains contenus, comme le commentaire politique, qui mêle opinion et faits et où aucun article n'en remplace nettement un autre. PTR laisse passer beaucoup d'articles qui s'usent lentement : leur part prédite reste sous le seuil, et certains restent dans le fil alors qu'ils sont déjà un peu périmés. Enfin, une part importante des signalements restants concerne des contenus que le lecteur a déjà vus, sur Discover ou ailleurs, ce qui sort du champ de SDF.
Le papier annonce aussi la suite. Le modèle de supersession est régulièrement mis à jour avec des modèles de langage plus récents. PTR doit s'enrichir d'un raisonnement par modèle de langage multimodal, et estimer la durée de vie en continu, au lieu de sept horizons fixes.
Les deux filtres dans un fil Discover
Des exemples transposés en français
Les exemples du papier sont américains. Dans un fil français, les deux mécanismes s'appliqueraient ainsi. Ces cas sont des illustrations de notre cru.
Pour la supersession :
- « Un milieu de terrain proche de signer à Marseille » devient périmé quand paraît « Le milieu de terrain a signé à Marseille ».
- « PSG-OM : à quelle heure et sur quelle chaîne » devient périmé quand paraît « PSG-OM : les notes des joueurs ».
- « La canicule s'installe », publié mardi, devient périmé avec « La canicule recule, orages prévus », publié mercredi.
- « 12e étape du Tour : le parcours et les favoris » devient périmé avec le récit de la victoire d'étape.
Le cas CoreLogic a son équivalent : une analyse sur les finances d'un club, publiée avant un transfert, peut rester fraîche après l'annonce si l'article sur le transfert parle d'autre chose.
Pour la décroissance :
- « Perséides : où et quand les observer cette nuit » perd son intérêt après le pic, comme le guide des Géminides du papier.
- Le programme de la Fête de la musique ne sert plus après le 21 juin au soir.
- Un guide de salon ou de festival qui dure une semaine reste utile pendant toute sa durée, comme celui de Phuket.
- Une recette de pâte brisée reste sous le seuil, comme l'article explicatif du New York Times.
Notre panel a reçu des avant-matchs de la finale Michigan-UConn après le résultat
Nos données contiennent un cas net de supersession manquée. La finale du championnat universitaire américain de basket, Michigan contre UConn, s'est jouée le 6 avril 2026 au soir, heure américaine. Le tableau reprend, dans l'ordre d'affichage, les cartes de l'un des fils anglophones de notre panel (un fil est le flux Discover d'un de nos comptes de test), le fil A de la figure plus bas.
| Moment de l'affichage (UTC) | Titre de la carte | Statut |
|---|---|---|
| 6 avril, soir | « Your NCAA championship guide: Michigan vs. UConn predictions » | avant-match, à jour |
| 6 avril, soir | « Solo Ball injury update: UConn guard injured ahead of game » | avant-match, à jour |
| 7 avril, mi-journée | « FULL Trophy Presentation Ceremony Michigan Wins the 2026… » | résultat |
| 7 avril, soir | « Michigan holds off UConn, wins second NCAA basketball title » | résultat |
| 7 avril, soir, 3 minutes après le résultat | « How to Watch UConn vs. Michigan Men's National Championship » | avant-match, périmé |
| 7 avril, soir, 5 minutes après le résultat | « Can Michigan beat UConn without a 100% Yaxel Lendeborg? » | avant-match, périmé |
Un second fil, le fil B, montre la même chose le même soir : « UConn star Solo Ball expected to play » y arrive plus de huit heures après la carte de la remise du trophée, et deux minutes avant « Michigan basketball wins its first national title since 1989 with 69-63 ».
On retrouve ici le cas Oakland-Rangers du papier. Le résultat est connu, et l'avant-match n'apprend plus rien au lecteur. Ces cartes ont pourtant été servies plus de quinze heures après la fin du match, à côté du résultat. Le filtre réduit la part du périmé sans la supprimer : dans le test du papier, 4,33 % des articles que SDF fait monter restent jugés périmés. Nous ignorons pourquoi ces paires lui ont échappé. Peut-être le système a-t-il rangé le guide et le résultat dans deux sujets différents, ou le modèle s'est-il trompé sur la paire.
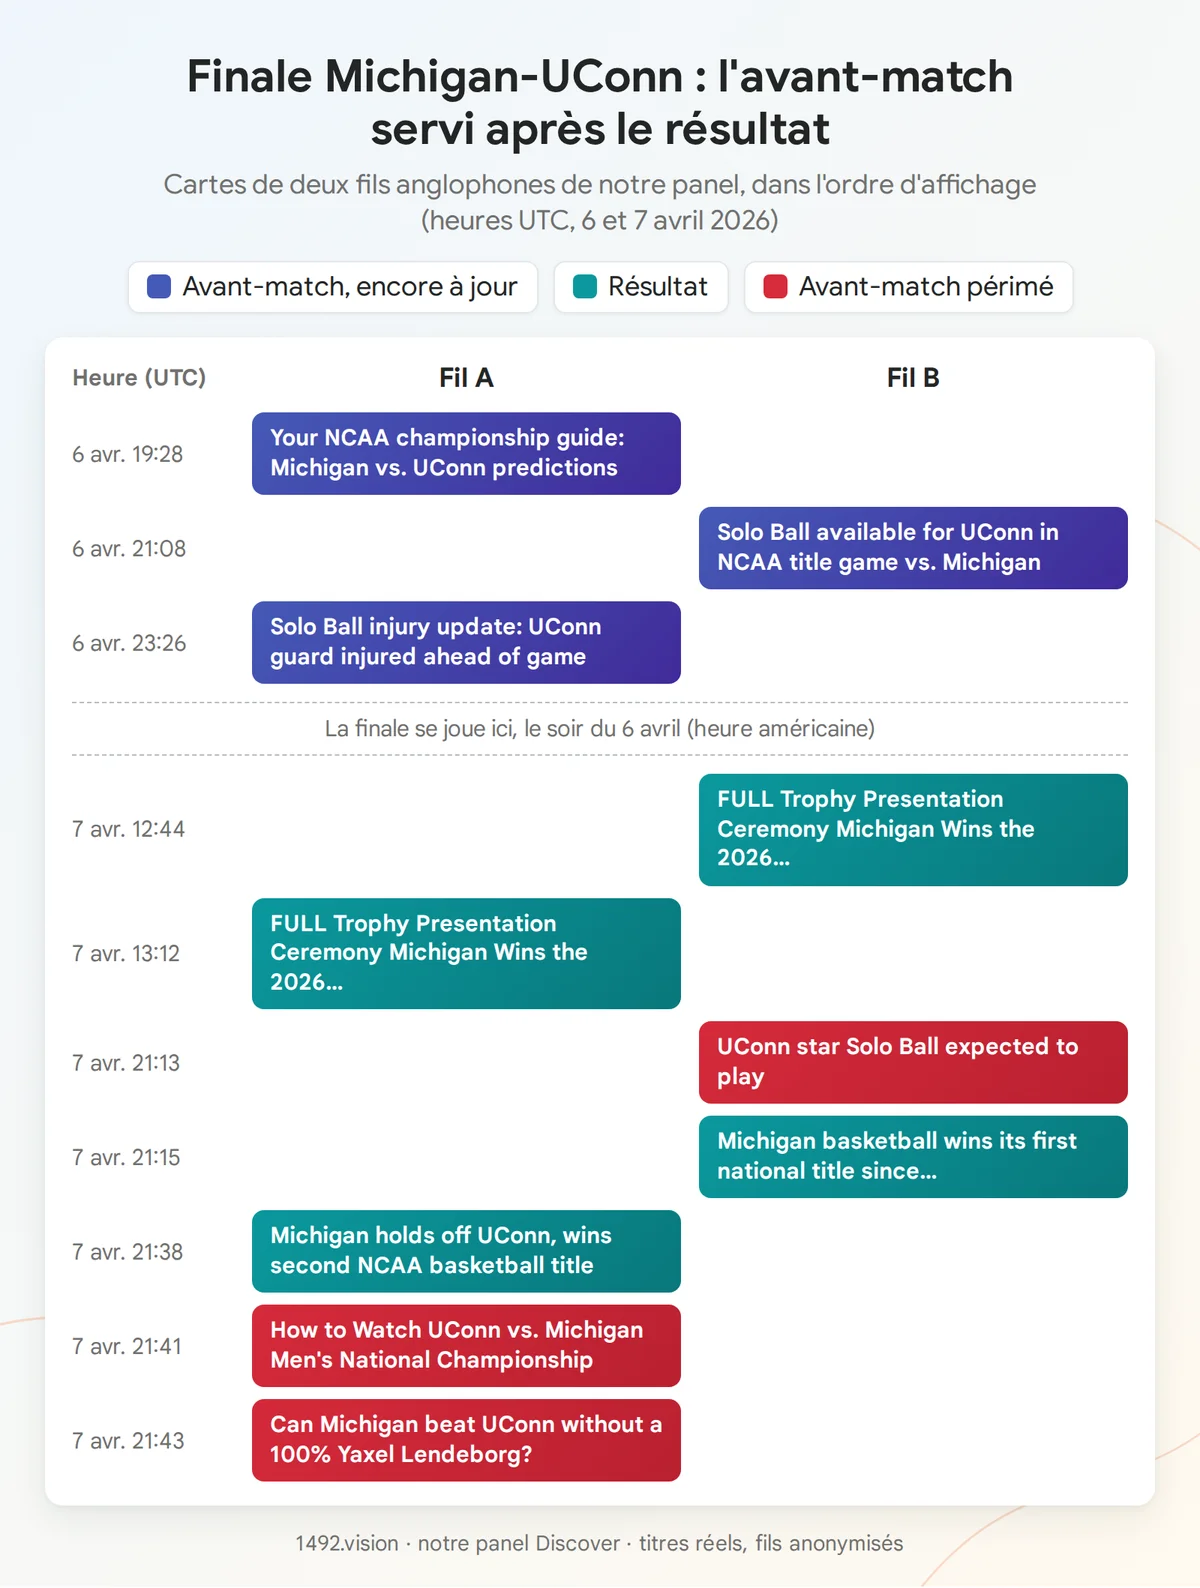
Deux fils anglophones de notre panel, notés fil A et fil B, autour de la finale universitaire Michigan-UConn, les 6 et 7 avril 2026. Le 7 avril au soir, des cartes d'avant-match sont encore servies à quelques minutes des cartes de résultat, plus de quinze heures après la fin du match.
Les guides d'événement disparaissent du fil dès le lendemain
Sur environ 35 400 articles vus dans notre panel, vidéos et réseaux sociaux exclus, 3,9 % apparaissent sur au moins deux jours différents. Pour les titres de type guide d'événement (« à quelle heure », « sur quelle chaîne », « how to watch », « ce soir », « en direct »), la part tombe à 0,9 %, sur 350 articles. Ces guides disparaissent presque tous dès le lendemain, comme le prévoit le filtre de décroissance.
Dans nos données, les recettes et le jardin reviennent pourtant moins souvent que la moyenne (2,0 % dans les deux cas, contre 3,9 %). Notre panel suit surtout des profils d'actualité et de tech. Sur ce point, les durées par catégorie du journal 1492, mesurées sur un panel bien plus large, sont plus fiables.
Nos observations dans Discover
Les chiffres de cette partie viennent de notre panel de fils Discover, suivi de mars à octobre 2026. Le journal de bord 1492, qui mesure le marché entier, n'y est cité que pour comparaison.
Les articles affichés ont rarement plus de deux jours
Une partie des articles servis porte sa date de publication dans son adresse, ce qui donne leur âge au moment de l'affichage. Sur environ 23 700 cartes datées, 39 % sont affichées le jour même de la publication, 36 % le lendemain et 15 % le surlendemain. Les articles de 3 jours ou plus font un peu plus de 10 % du total, ceux de 7 jours ou plus 0,8 %.
Sur un même ensemble de cinq fils suivis de mars à octobre, la part d'articles de 3 jours ou plus évolue par à-coups :
| Mois | Mars | Avril | Mai | Juin | Juillet | Août | Septembre |
|---|---|---|---|---|---|---|---|
| Articles de 3 jours ou plus | 9 % | 8 % | 15 % | 13 % | 12 % | 8 % | 8 % |
Entre mai-juin et août-septembre, la part d'articles de 3 jours ou plus baisse dans chacun des cinq fils. La part des articles de 7 jours ou plus passe de 1,2 % à 0,6 %.
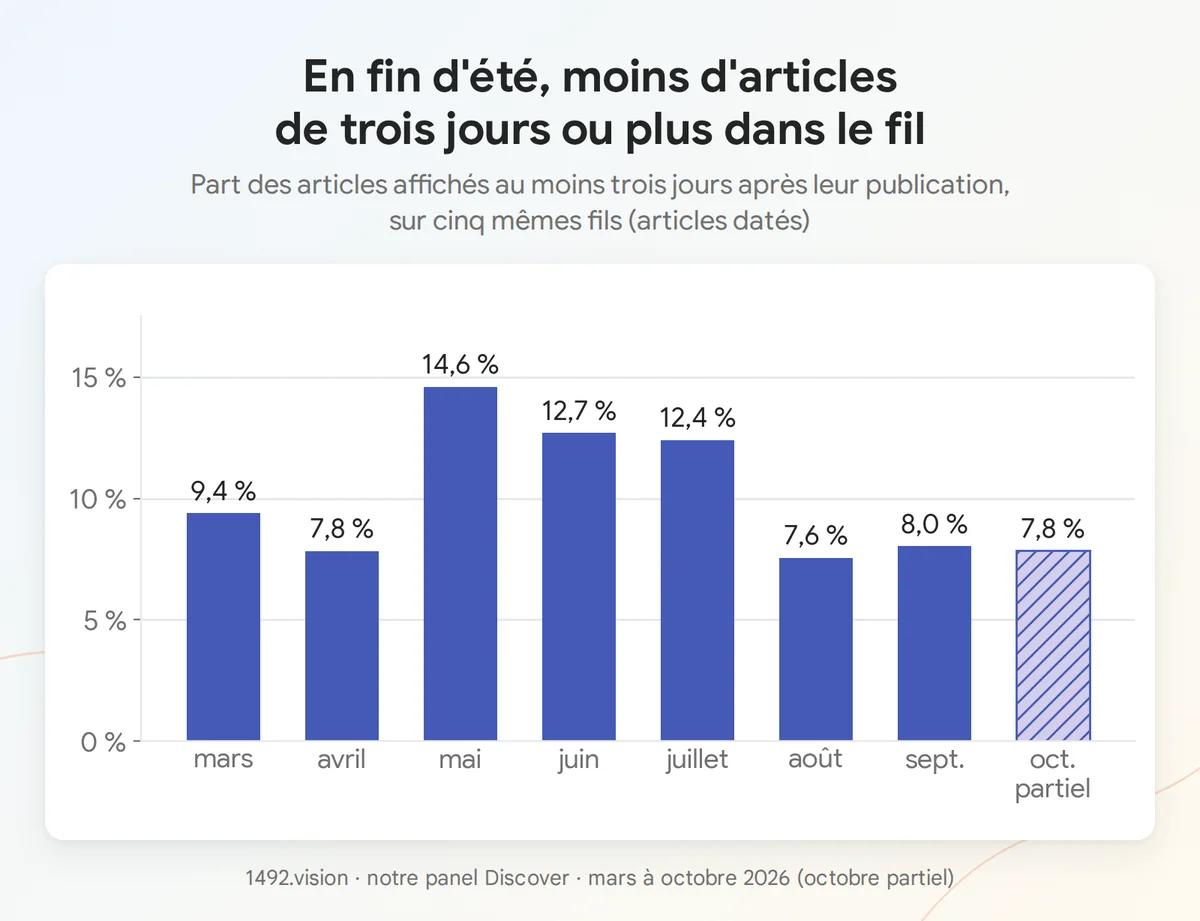
Part des articles affichés trois jours ou plus après leur publication, par mois, sur un même ensemble de cinq fils de notre panel, suivis de mars à octobre 2026 (articles dont l'adresse contient une date). Octobre est partiel.
Le fil de la fin d'été est plus jeune que celui de mai-juin, ce qui va dans le sens d'une fin de vie plus précoce. Le recul n'apparaît toutefois qu'en août, et mars-avril étaient déjà à ce niveau. Une saison chargée en sujets longs, avec la Coupe du monde de football du 11 juin au 19 juillet, pourrait aussi expliquer une partie de la hausse de mai à juillet.
L'audience d'un article décroche après trois jours
Notre mesure d'audience, le nombre d'affichages d'un article dans les flux de notre panel, suit l'article au jour le jour, sans cumul : elle monte avec sa diffusion et redescend quand il quitte le fil.
Pour 934 articles datés vus au moins trois fois, nous avons pris, pour chaque âge, l'audience médiane des articles encore vus ce jour-là, rapportée à leur meilleur jour. Le jour de la publication, elle est à 45 % du meilleur jour. Elle l'atteint le lendemain (J+1), reste au-dessus de 80 % jusqu'à J+3, puis décroche : 56 % à J+4, 50 % à J+5 et 21 % à J+6.
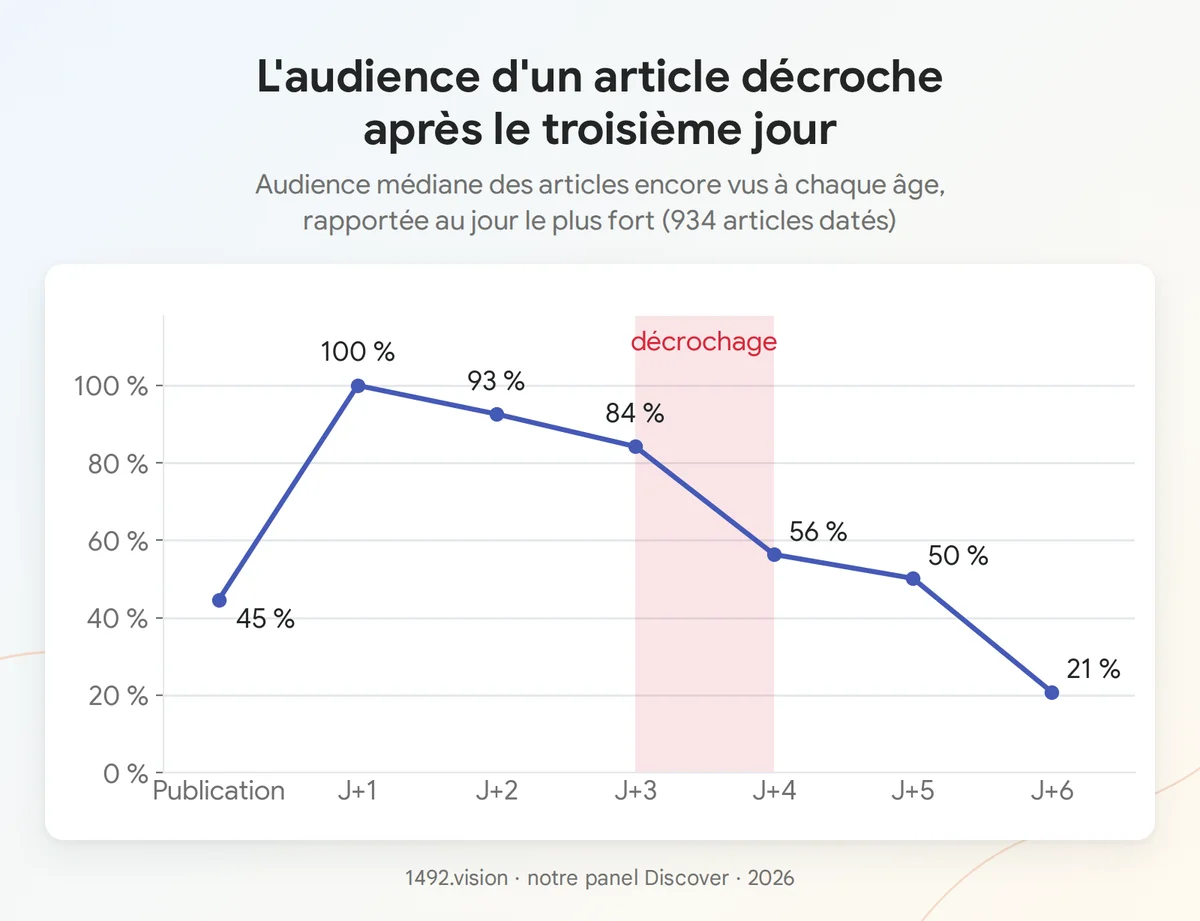
Audience médiane des articles encore vus à chaque âge, rapportée au meilleur jour (934 articles datés vus au moins trois fois). Le décrochage se produit entre J+3 et J+4.
Un article qui quitte le fil puis y revient repart souvent de plus bas, comme une nouvelle recommandation : c'est le cas de 46 % des articles revus après trois jours d'absence, et de 76 % après cinq jours ou plus, sur quelques dizaines de cas seulement. Ce second passage atteint en médiane 58,5 % du meilleur jour du premier.
Parmi ces retours, ceux des sites tech (onze sites, dont Frandroid, Numerama et Clubic) relancent le plus souvent leur audience, à plus de 5 % au-dessus de son niveau de reprise : 3 retours sur 27, soit 11 %, contre 2 sur 36 pour les grands sites d'information et 1 sur 22 pour la vidéo.
Trois jours correspondent à la borne que le papier donne à l'actualité du jour quand il justifie ses horizons (« daily reporting at 1 to 3 days ») : passé ce cap, un article d'actualité a en principe reçu la plus grande part de son trafic.
Le score de potentiel de sujet comparé à PTR
Parmi les scores que nous suivons, l'un se rapproche de PTR. Nous l'appelons score de potentiel de sujet, comme dans nos articles précédents sur la prédiction dans Discover. Il va de 0 à 1 et semble estimer le volume d'engagement qu'un article peut attendre, tous lecteurs confondus. Entre le cinquième des articles les moins bien notés et le cinquième des mieux notés, notre mesure d'audience est multipliée par 2,6. Ce lien s'observe sur des ensembles d'articles : pris un par un, un article peu noté dépasse parfois un article mieux noté.
Le score dépend plus du sujet que de l'éditeur. Le 10 octobre, dans un même fil, Le Figaro obtient environ 0,29 pour un article sur l'accord pétrolier entre Moscou et Washington, et 0,022 pour un reportage sur une goélette amarrée à Bordeaux, treize fois moins. Ces valeurs d'octobre sont plus basses qu'au printemps, depuis la baisse de fin juin décrite plus bas. Un score bas ne dit rien de la qualité : les articles dont l'adresse reprend une formule racoleuse obtiennent en moyenne le même score que les autres (0,187 contre 0,183 sur environ 23 500 articles, au printemps).
Le score varie peu d'un lecteur à l'autre : pour un même article vu le même jour, l'écart médian entre fils est de 0,04, avec quelques exceptions nettes. Il reste aussi stable quand l'article vieillit. Sur environ 11 500 cas où un même fil revoit un même article un jour plus tard ou davantage, le score médian reste identique, et il varie de moins de 0,005 dans 82 à 90 % des cas. PTR mesure au contraire, par construction, le vieillissement de l'article.
Comme PTR, ce score est calculé sur le contenu, il est très peu personnalisé et il agit avant le classement. Mais il estime un volume d'engagement, là où PTR estime une part de vie déjà écoulée.
| PTR, filtre de décroissance | Score de potentiel de sujet | |
|---|---|---|
| Ce qu'il estime | La part de la vie de l'article déjà écoulée | Le volume d'engagement attendu |
| Nature | Un ratio de 0 à 1, qui dépend de l'âge | Un niveau propre à l'article, stable avec l'âge |
| Personnalisation | Aucune | Très faible |
| Effet | Servi ou retiré | Seuil d'entrée, puis poids dans l'amplification |
| Source | Papier SDF | Nos observations |
Ce score fonctionne comme un seuil d'entrée. Avant juillet, sous 0,10 à 0,12 environ, un article avait peu de chances d'être amplifié. Au printemps 2026, sur un petit nombre d'articles, CuisineAZ affichait un potentiel de 0,094 et Marmiton de 0,229. Le premier recevait une amplification négative sur 40 % de ses articles, le second jamais, alors que CuisineAZ devançait Marmiton sur le premier des deux scores de service13. Dans nos observations, ce seuil vient en premier : un article qui reste sous ce seuil est rarement amplifié. Les scores d'engagement prédit, propres à chaque lecteur (voir notre article sur les signaux des cartes Discover en 2026), fixent ensuite le niveau d'amplification, et le fait de suivre la source joue surtout sur l'étendue de la diffusion.
L'audience maximale baisse d'un tiers chez un même éditeur
Le journal 1492 mesure la baisse sur tout le marché. Nous avons vérifié si elle se retrouve dans notre panel éditeur par éditeur, pour écarter un simple changement de composition du fil. Pour 135 domaines présents avec au moins 20 articles en mai-juin et en août-septembre, nous comparons l'audience maximale atteinte par article, en médiane.
| Périmètre | Domaines | Rapport médian | Éditeurs les plus exposés | Éditeurs les moins exposés |
|---|---|---|---|---|
| Tous les fils | 135 | 0,68 | 0,50 | 0,87 |
| Articles vus au moins deux jours | 41 | 0,52 | 0,38 | 1,00 |
| Fils anglophones | 81 | 0,68 | 0,52 | 0,84 |
| Fils francophones (au moins 10 articles par période) | 41 | 1,18 | 0,41 | 1,50 |
Rapport de l'audience maximale médiane par article, août-septembre 2026 sur mai-juin 2026, éditeur par éditeur. 1 signifie aucun changement. Les plus exposés sont les 25 % de domaines dont les articles avaient la plus forte audience en mai-juin, les moins exposés les 25 % à la plus faible. Les effectifs ne s'additionnent pas : chaque périmètre applique son seuil aux seuls articles de ses fils, et un domaine peut figurer dans les deux langues.
Le rapport médian est de 0,68 : un article type de ces éditeurs atteint en août-septembre environ deux tiers de l'audience qu'il atteignait en mai-juin. La baisse touche 76 % des domaines. Elle est plus forte chez les éditeurs les plus exposés (0,50) que chez les moins exposés (0,87), et plus forte encore sur les articles vus au moins deux jours (0,52), ceux qui ont une fin de vie à perdre. Mesurée à la première apparition de l'article plutôt qu'à son maximum, elle reste du même ordre (0,70). Notre rythme d'observation explique donc peu la baisse.
Les fils francophones donnent un résultat plus contrasté, sur un échantillon plus petit : le rapport médian y dépasse 1 (1,18). Les éditeurs les plus exposés y reculent nettement (0,41) et les moins exposés progressent (1,50). Le journal 1492 décrit une bascule d'une autre nature : la presse nationale y perd un quart de sa part de voix quand la presse régionale la triple. Nous classons ici les éditeurs selon leur exposition, le journal selon leur type : les deux résultats se comparent mal.
Sur les mêmes domaines, le score de potentiel moyen baisse lui aussi d'environ 30 % (rapport de 0,70), pour la quasi-totalité d'entre eux. Sur l'ensemble du panel, semaine par semaine, la baisse est d'un quart (voir plus bas). Le score a donc baissé chez chaque éditeur : le mélange des contenus est hors de cause.
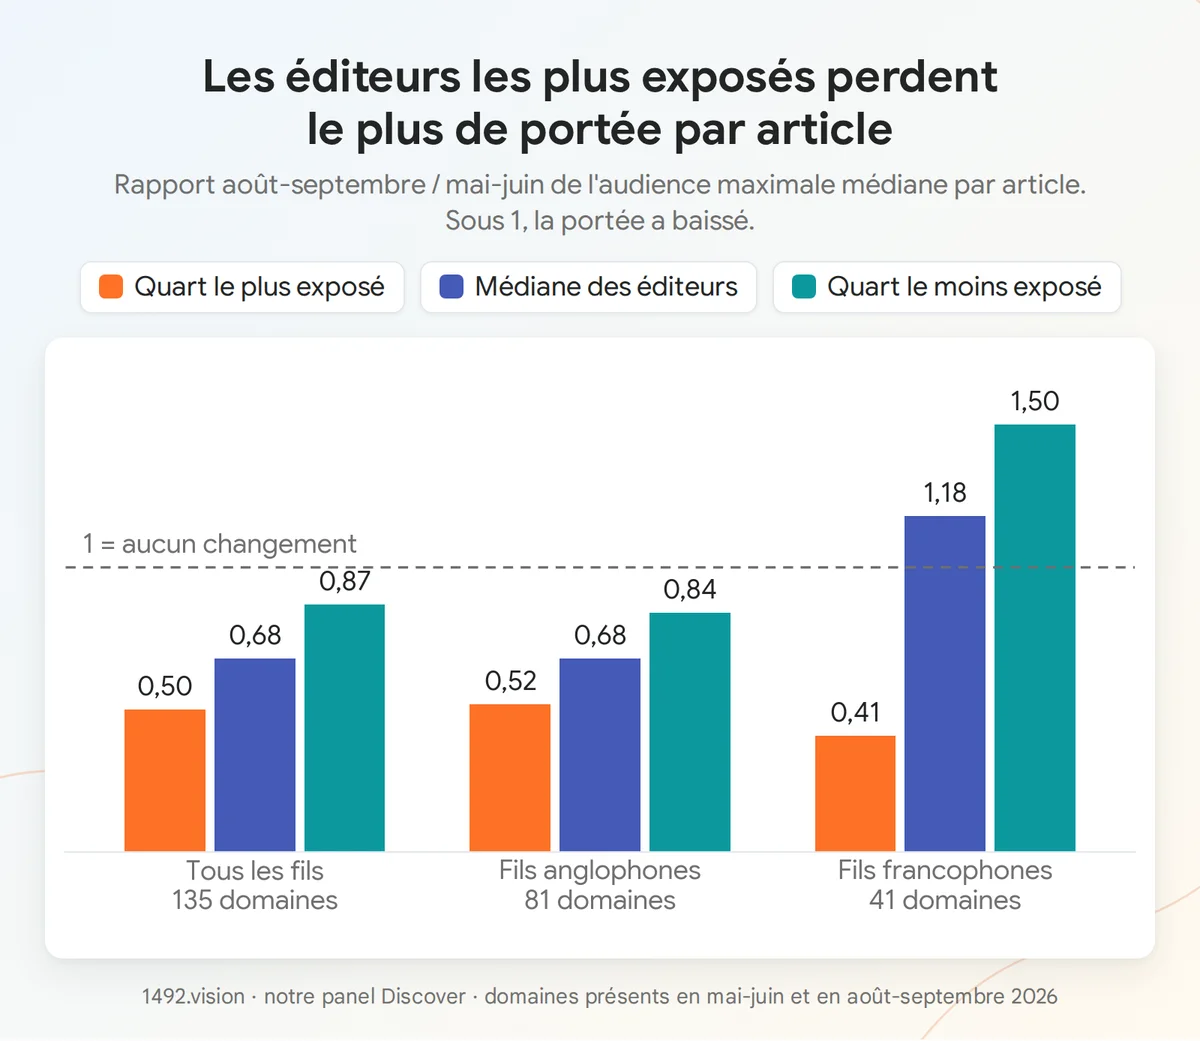
Rapport de l'audience maximale médiane par article, août-septembre sur mai-juin 2026, selon l'exposition des éditeurs en mai-juin. 1 signifie aucun changement. Les fils anglophones et francophones sont séparés, et les effectifs des trois groupes ne s'additionnent pas (voir le tableau).
Un modèle qui prédit un volume d'engagement, réentraîné sur un fil où les articles restent moins longtemps, apprendrait mécaniquement des volumes plus bas. Un simple réétalonnage du score, sans lien avec la péremption, produirait toutefois la même baisse, et nos données ne permettent pas de départager les deux hypothèses.
Plusieurs scores de Discover changent entre le 30 juin et le 3 juillet 2026
Dans nos fils anglophones, plusieurs scores que nous suivons changent de forme dans la même semaine. Le 30 juin, deux nouveaux scores de prédiction apparaissent sur la plupart des cartes. Entre le 1er et le 3 juillet, un autre score de prédiction, jusque-là plafonné à 1, peut désormais dépasser cette valeur. Le 1er juillet, une classification thématique des articles apparaît sur presque toutes les cartes. Du 30 juin au 3 juillet, les deux scores de service qui accompagnaient le score de potentiel cèdent la place à deux nouveaux. L'un des disparus est celui que nous appelions score de confiance de service, resté pour nous une énigme.
Le score de potentiel suit le mouvement. En indice (100 = moyenne du 1er avril au 14 juin), il reste entre 82 et 116 jusqu'à la semaine du 22 juin, autour de 99 en moyenne. À partir de la semaine du 29 juin, il reste entre 63 et 83, autour de 75, jusqu'en octobre. Au printemps, seule la semaine du 15 juin était descendue dans cette fourchette.
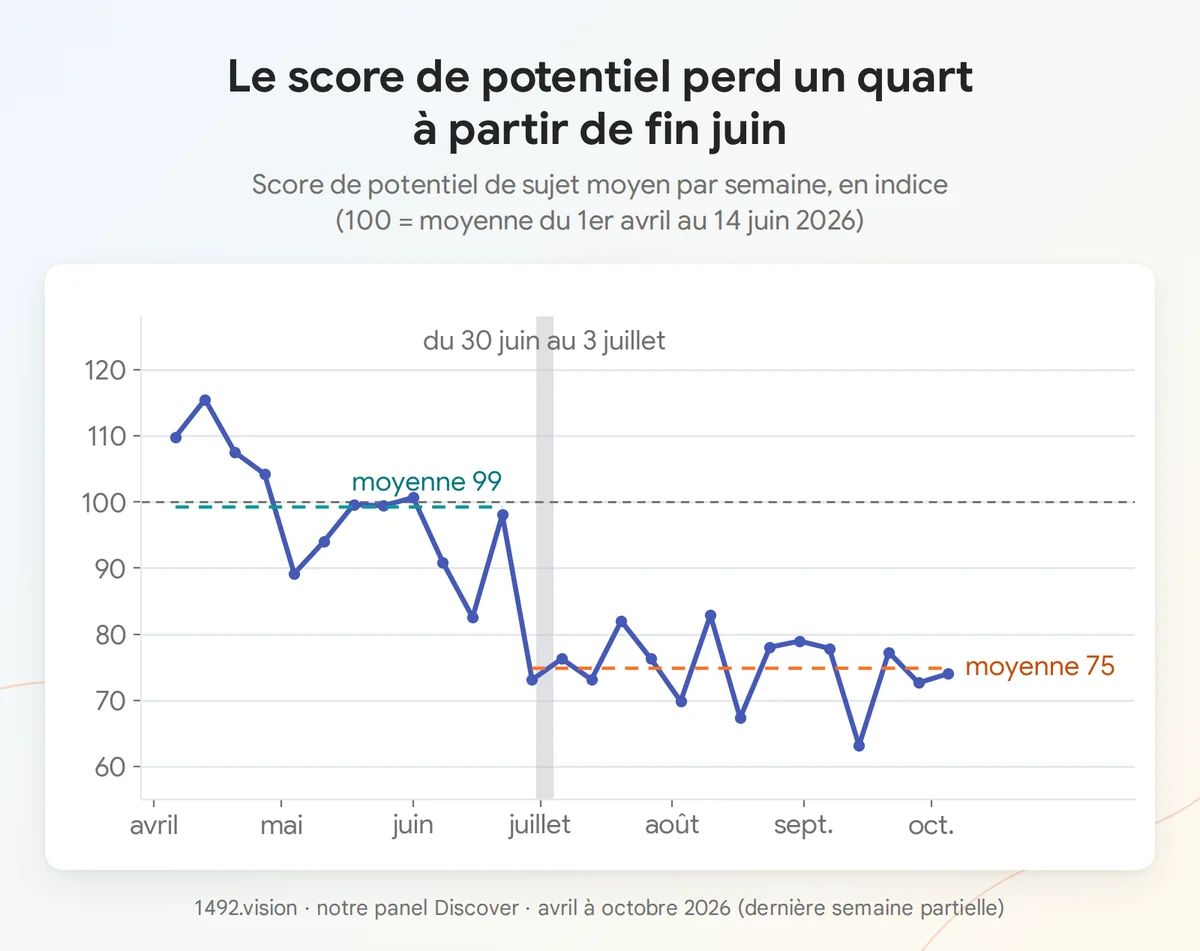
Score de potentiel de sujet moyen par semaine, en indice (100 = moyenne du 1er avril au 14 juin 2026). La bande grisée marque la semaine du 30 juin au 3 juillet, où plusieurs scores changent de forme.
Cette semaine coïncide avec le début de la baisse relevée par le journal 1492, qui situe la cassure en juillet. Rien ne permet en revanche de l'attribuer à SDF : les changements que nous voyons touchent des scores de prédiction et de potentiel, donc le classement et l'entrée dans le fil. Et le papier évoque des mises à jour successives sur deux ans, sans les dater.
L'amplification reste stable quand l'article vieillit
Deux de nos tests cherchaient un effet du temps sur la diffusion d'un article. L'amplification d'un article reste stable d'un jour à l'autre : sur 207 paires d'observations du même article dans le même fil, à un ou deux jours d'écart, elle est restée identique. Nous avons aussi cherché une usure au sein d'une même session, où un article perdrait de sa force à chaque réaffichage : nos contrôles l'ont écartée.
Dans Discover, le temps semble donc agir comme une porte (l'article est servi ou non) et non comme une pente qui le rétrograderait peu à peu. SDF fait le même choix. Ses auteurs reprochent aux classements fondés sur l'âge de seulement rétrograder les articles périmés, que le lecteur doit encore faire défiler.
La fraîcheur a ses propres canaux. Notre étude des pipelines de Discover en décrit qui semblent dédiés au contenu récent, à commencer par freshvideos pour la vidéo ; SDF agit à l'autre bout, sur le contenu périmé.
Mises en perspective
La même équipe décrit aussi le classement de Discover
Quatre des six auteurs de SDF, Di Bai, Zhenwei Tang, Jintao Liu et Luoshu Wang, signent aussi un papier présenté à la conférence RecSys 2026 sur le classement de Discover (arXiv 2607.27577). Il décrit le modèle de classement en production : un seul réseau de neurones qui prédit 11 comportements à la fois, positifs (clics, mentions « j'aime ») ou négatifs (rejets, blocages). Il teste aussi sur 1 % du trafic de Discover une variante, HA-MoE, qui répartit le travail entre plusieurs sous-modèles spécialisés, présentée comme prête pour la production. SDF intervient juste avant ce modèle de classement. Lus ensemble, les deux papiers décrivent la chaîne : des candidats, un tri du périmé, puis un classement à plusieurs objectifs.
De notre côté, nous isolons aujourd'hui environ neuf scores de prédiction par carte, dont les deux apparus le 30 juin. 1492 décrit publiquement cette famille de scores depuis décembre 2025. On y retrouve les deux familles du papier : certains montent avec l'engagement, comme le score d'engagement profond, d'autres estiment un désintérêt, comme le score de « scroll-past », le risque que le lecteur fasse défiler la carte sans s'y arrêter. Le papier garde pour lui la liste de ses 11 prédictions : impossible pour l'instant de rattacher chacun de nos scores à l'une d'elles. Nous ignorons aussi si HA-MoE a été déployé depuis son test. Nous consacrerons un prochain article à ce papier et à nos scores.
Discover regroupe les articles d'un même sujet
Discover attache parfois un même identifiant de sujet à des articles de plusieurs éditeurs, sans doute pour limiter la place qu'une même histoire prend dans le fil. Dans nos données de mars à mai 2026, les groupes ainsi formés réunissent 2 à 7 domaines et durent le plus souvent 1 à 4 jours. Parmi ceux qui comptent au moins trois articles, 86 % partagent une même entité. Le 10 avril, dans l'un de nos fils, trois articles sur Anthropic, signés Presse-citron, Developpez.com et Clubic, portent ainsi le même identifiant. Ils apparaissent à environ une heure d'intervalle.
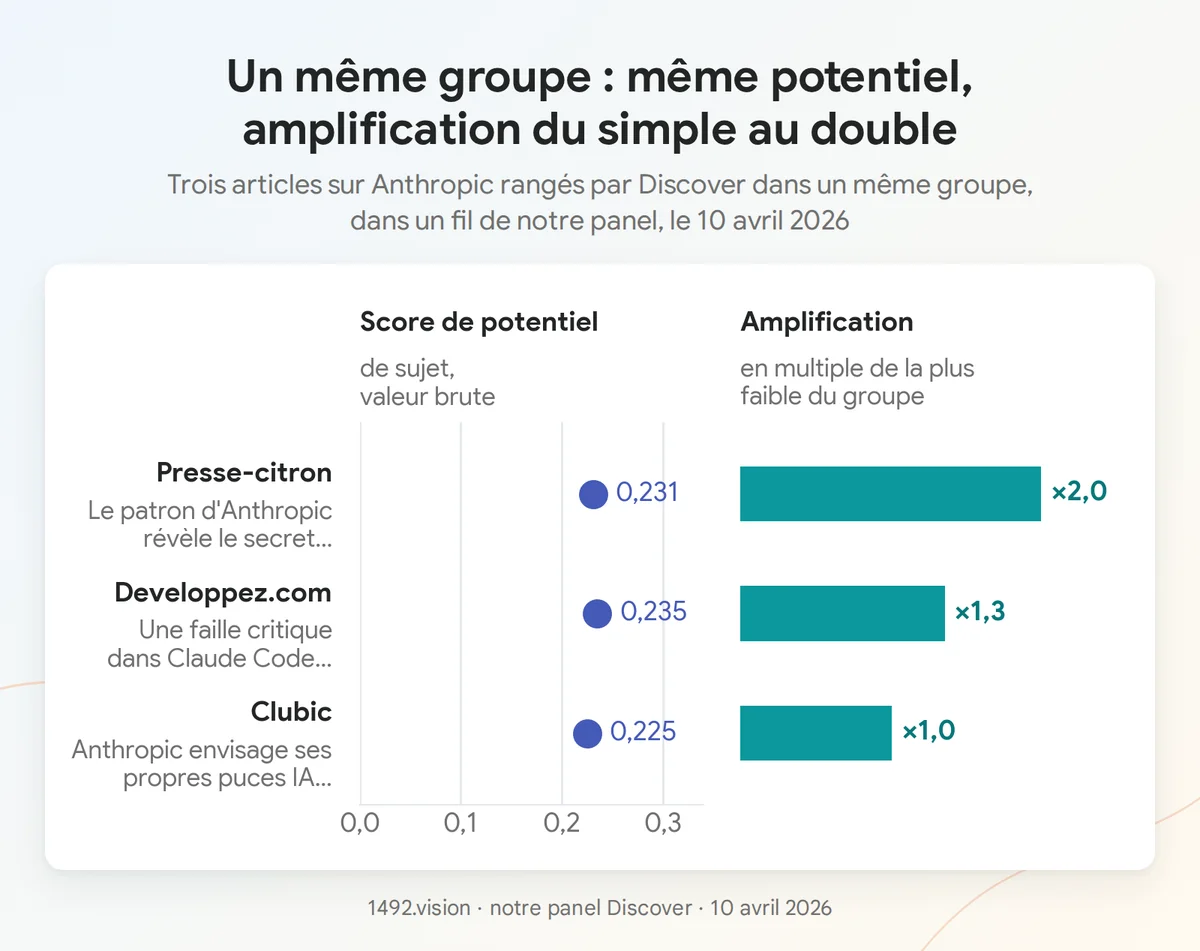
Un groupe vu de près, dans un fil de notre panel, le 10 avril 2026. Les trois articles apparaissent à environ une heure d'intervalle. Leur score de potentiel est presque identique, de 0,225 à 0,235, et leur score d'amplification va du simple au double. L'amplification est exprimée en multiple de la plus faible des trois, ce qui n'a de sens que parce que les trois sont positives ici. Titres abrégés.
En moyenne, l'article le plus servi d'un groupe et le moins servi ont presque le même score de potentiel et le même engagement prédit. Le plus servi atteint pourtant une audience environ 6 fois plus forte, et plus de 100 fois plus forte dans 33 groupes sur 455. Son amplification est en moyenne 14 % plus forte seulement, et elle explique une partie de l'écart : le moins servi est aussi le moins amplifié dans 55 % des groupes, pour 45 % attendus au hasard. Ce hasard est d'une chance sur deux dans les groupes de deux articles, qui font les trois quarts du total, et moins dans les groupes plus grands. L'amplification suit davantage le potentiel : l'article au potentiel le plus bas est aussi le moins amplifié dans 66 % des groupes, pour le même hasard.
Sur un même sujet, un article doit donc d'abord survivre aux articles plus récents (la supersession), puis gagner son groupe au classement. Nous avons cherché si le gagnant est plus souvent le plus récent, ce qui serait la marque d'une supersession. Il l'est dans 44 % des groupes, pour 46 % attendus au hasard. Le test est fragile, parce que notre mesure avantage les articles présents depuis plus longtemps.
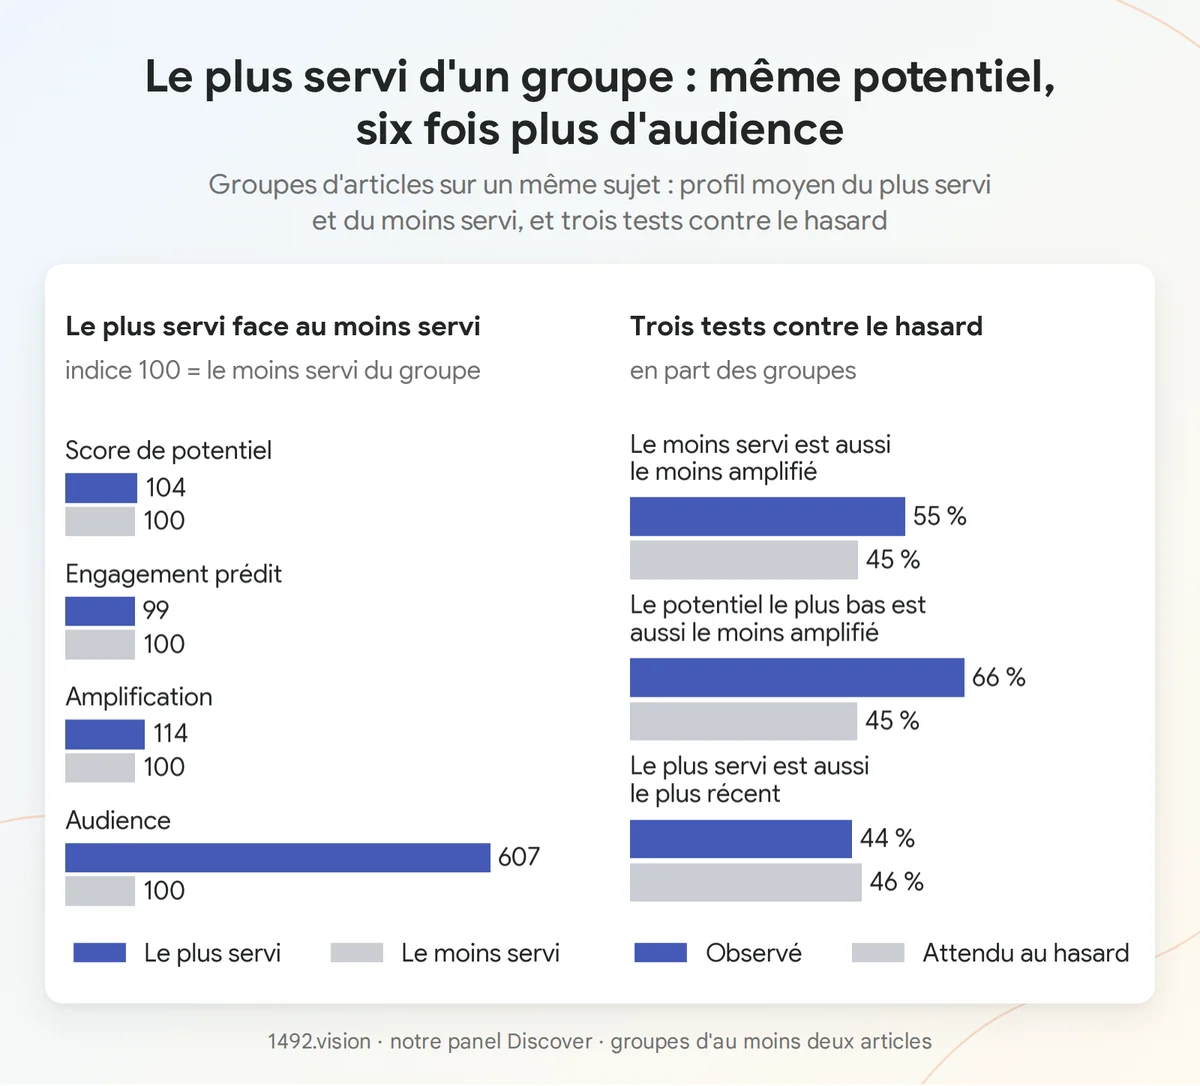
À gauche, le plus servi face au moins servi d'un même groupe, en indice (100 = le moins servi). À droite, trois tests contre le hasard, en part des groupes. Le hasard est d'une chance sur deux dans un groupe de deux articles et moins dans les groupes plus grands, soit 45 % en moyenne. Le profil et les deux premiers tests portent sur 455 groupes d'au moins deux articles, de mars à mai 2026, le test de récence sur les 221 groupes où il est possible.
Le lecteur a sa propre horloge
SDF est l'horloge de l'article. Le lecteur a la sienne. Dans nos données, le poids d'un centre d'intérêt dans le fil d'un lecteur, une valeur calculée par Google que nous relevons dans les données du flux, baisse avec le temps passé sans le voir : d'environ 2 % après 1 à 3 jours, 4 à 5 % après 4 à 7 jours et 14 % après 8 jours ou plus, cette dernière tranche reposant sur un petit échantillon. La baisse suit la durée ; le nombre de fois où le lecteur a ouvert son fil sans y trouver ce sujet reste sans effet. Cette logique rappelle un brevet de Google sur la pondération des intérêts récents (US8972391, « Recent Interest Based Relevance Scoring »).
Google publie sur l'âge des contenus depuis 2008
L'âge des contenus est une vieille question chez Google. En 2008, le brevet US7346839 (« Information retrieval based on historical data », dont Matt Cutts et Jeff Dean figurent parmi les inventeurs) la lit dans les dates de mise à jour des documents et dans l'âge de leurs liens. Il note que des documents périmés trop bien classés « degrade the search results ». En 2016, le papier de YouTube sur ses réseaux de recommandation (Covington et al., RecSys 2016) prend le problème par l'autre bout : un modèle entraîné sur le passé sous-estime le neuf. Il fournit l'âge des exemples au modèle pendant l'entraînement, puis le met à zéro au moment de servir, parce que les utilisateurs préfèrent le contenu frais, « though not at the expense of relevance ». En 2023, YouTube décrit un système à plusieurs entonnoirs pour le contenu frais, fondé sur des seuils d'âge et d'interactions. Le papier SDF le cite comme exemple des pratiques qu'il veut dépasser. SDF, en 2026, prédit la péremption à partir du contenu, avec un modèle de langage et un modèle multimodal, et l'applique comme un filtre.
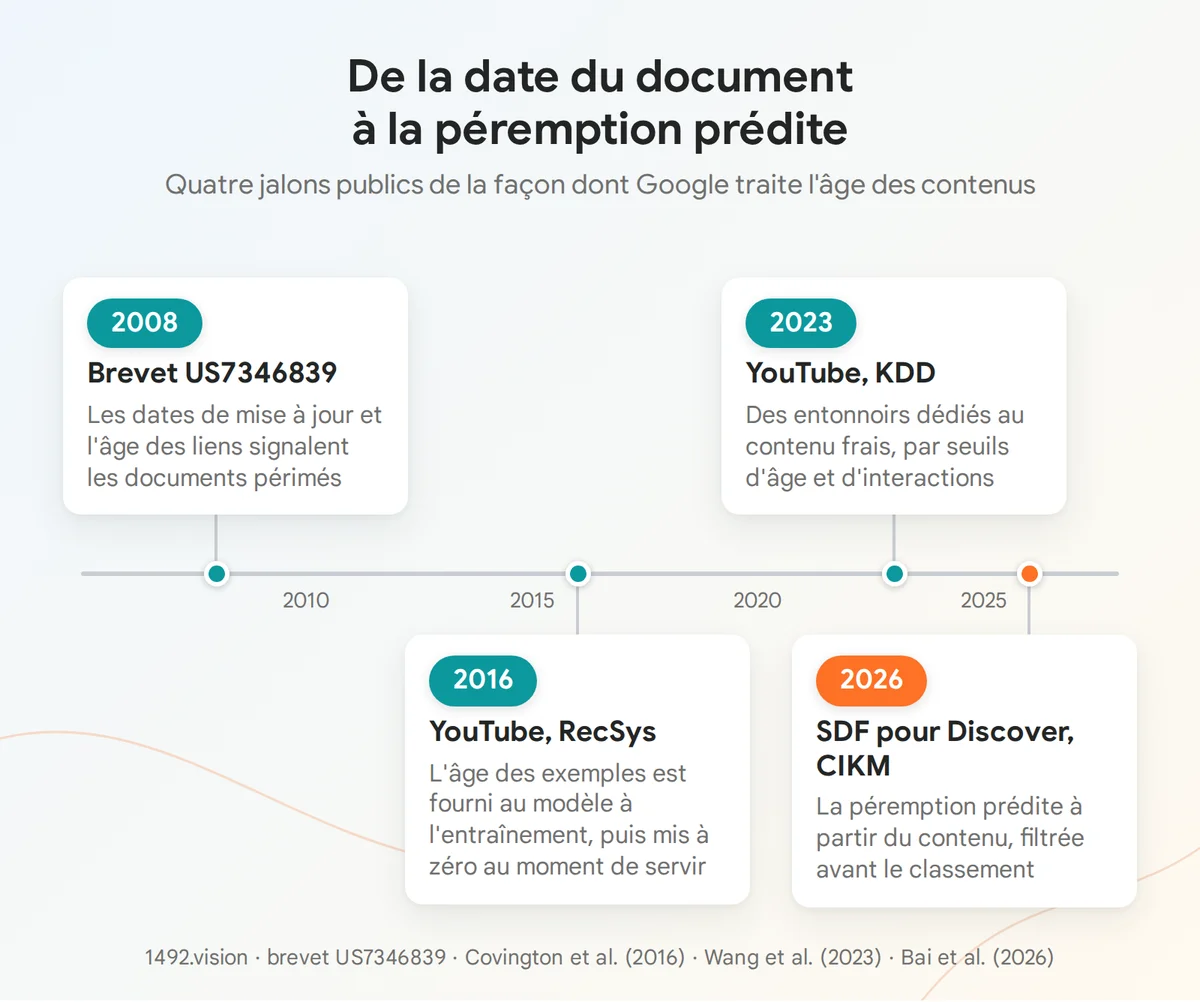
Quatre jalons publics sur l'âge des contenus chez Google : un brevet de recherche (2008), deux papiers YouTube (2016 et 2023) et SDF pour Discover (2026).
SDF et la baisse de portée relevée par 1492
Le journal de bord 1492 du 8 octobre 2026 part d'un constat : depuis juillet, les gros articles ont perdu un tiers de leur portée. Ses principaux chiffres :
- En septembre, la portée des 1 000 articles les plus exposés de chaque langue est à l'indice 68 en France, 66 en Italie, 60 aux États-Unis et 58 en Espagne (100 = janvier-février 2026).
- Le meilleur jour d'un article baisse peu (indice 88 en France). La baisse vient des jours suivants : entre les cohortes de février et de septembre, la part de la portée obtenue après le meilleur jour passe de 25 % à 17 %, et la durée d'exposition de 3,6 à 2,7 jours.
- Les contenus intemporels perdent le plus : le jardin passe de 5,4 à 3,3 jours d'exposition, les recettes de 5,3 à 3,4, contre 3,3 à 2,6 pour l'actualité et 2,6 à 2,2 pour le sport.
- Le flux est un peu moins concentré : en France, les dix articles les plus exposés du jour passent de 0,7 % à 0,6 % de l'exposition.
- La presse nationale perd un quart de sa part de voix, la presse régionale la triple. Les gains de la presse régionale viennent du flux généraliste : la part de ses expositions venue des pipelines de proximité (les canaux qui recommandent l'actualité locale) passe en médiane de 12,7 % à 1,6 %.
- Republier un même titre sous une nouvelle adresse garde le sujet visible environ 50 % plus longtemps, une pratique que 1492 déconseille.
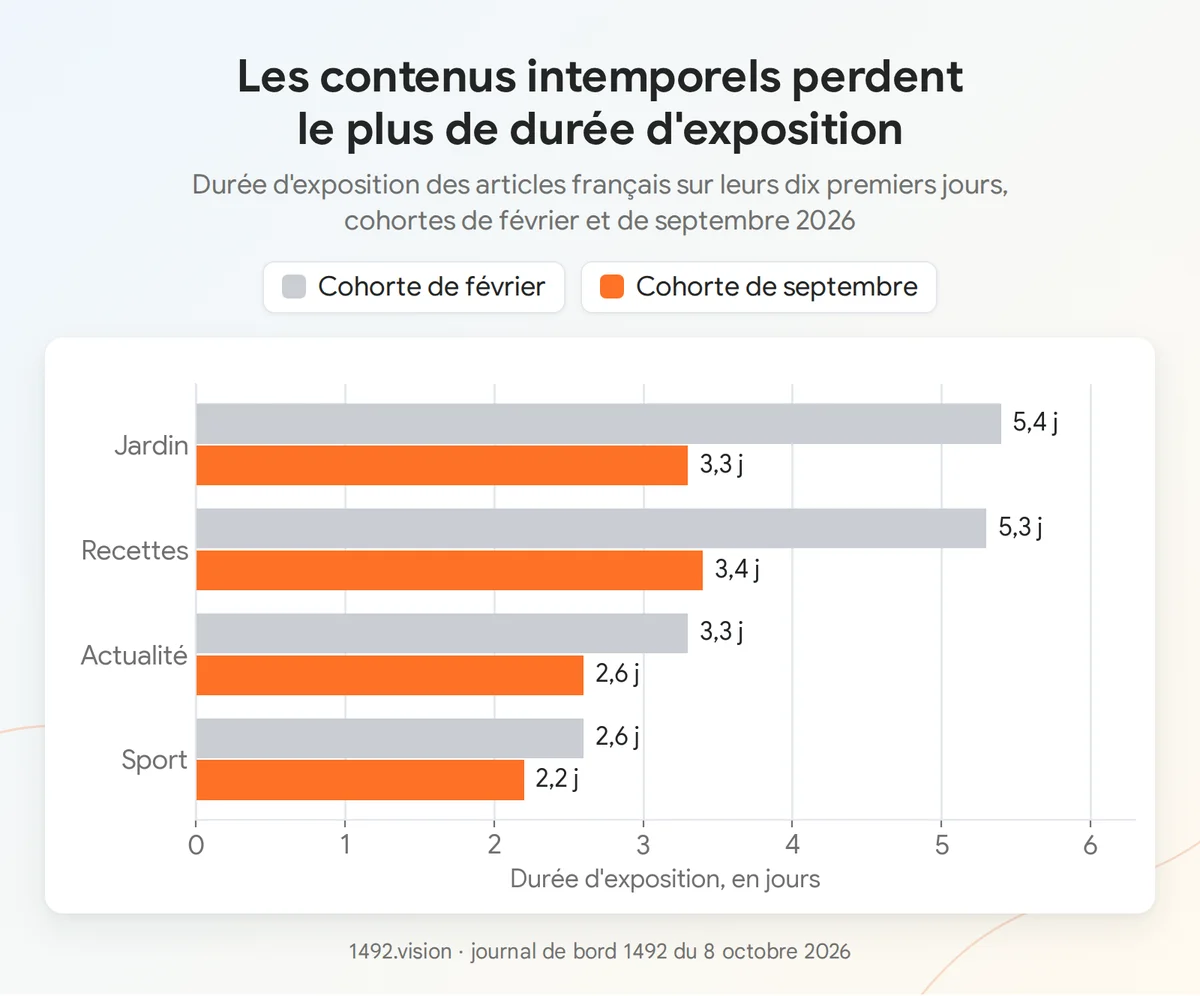
Durée d'exposition des articles français sur leurs dix premiers jours, cohortes de février et de septembre 2026, par type de contenu. Source : journal de bord 1492 du 8 octobre 2026.
SDF tournait déjà pendant la période qui sert de référence au journal : le papier mesure ses économies de calcul sur le premier trimestre 2026, avec les deux filtres en service. Le SDF qu'il décrit fait donc partie du point de départ (janvier-février 2026). Pour qu'il joue un rôle dans la baisse, il faudrait qu'il ait changé après mars.
Le papier laisse cette possibilité ouverte sans la dater. Il signale des mises à jour successives du modèle et une extension à d'autres langues et pays, et les auteurs disent travailler à enrichir PTR. Ils reconnaissent par ailleurs que PTR laisse passer « a long tail of gradually-decaying items », beaucoup d'articles qui s'usent lentement. Si une mise à jour déployée cet été retirait ces articles, elle couperait leur fin de vie et laisserait leur meilleur jour intact. Ce serait le profil que décrit le journal : un meilleur jour presque stable, et des contenus intemporels qui perdent le plus. Une extension de SDF à de nouvelles langues expliquerait mal, quant à elle, une baisse simultanée sur quatre marchés, États-Unis compris.
Sous cette réserve, nous avons confronté chaque constat au fonctionnement décrit par le papier.
| Constat du journal 1492 | Explication possible par SDF | Confiance |
|---|---|---|
| Baisse simultanée sur quatre marchés à partir de juillet | Un filtre identique pour tous les lecteurs et déployé dans plusieurs langues change partout à la fois quand son modèle ou son seuil change | Moyenne pour un changement global, faible pour SDF en particulier |
| Meilleur jour presque stable, traîne raccourcie | La règle de PTR coupe la fin de vie et laisse le meilleur jour intact, et les auteurs reconnaissent qu'elle laisse passer les articles qui s'usent lentement | Moyenne |
| Contenus intemporels les plus touchés, toutes les catégories ramenées vers 2 à 3 jours | Tel que décrit, PTR épargne l'intemporel. Il faudrait un modèle ou un seuil modifiés, par exemple avec la durée de vie continue annoncée | Faible |
| Republier sous une nouvelle adresse prolonge le sujet d'environ 50 % | L'horloge de PTR démarre à l'indexation : une nouvelle adresse repart de zéro, même si chacune disparaît aussi vite | Moyenne |
| Fil un peu moins concentré | Retirer les articles en fin de vie libère des places, et le test témoin du papier montre une diversité en hausse de 0,13 % | Faible |
| Presse régionale en hausse, pipelines de proximité en chute | SDF juge l'article seul, quels que soient l'éditeur et le lieu | Hors du champ de SDF |
Dans nos audits, chez un grand quotidien national, la part de sa production d'actualité admise dans Discover, c'est-à-dire vue dans les flux de notre panel, est passée de 82 % à 71 % en septembre, alors que l'amplification des articles admis restait positive dans environ 95 % des cas. Le recul se joue donc à l'entrée, ce qui est compatible avec un filtre en amont, SDF ou le seuil de potentiel, sans qu'on puisse dire lequel.
Les changements que nous datons du 30 juin au 3 juillet touchent surtout des scores de classement et de potentiel. Juillet combine sans doute plusieurs changements. SDF aide à lire la forme du raccourcissement de la vie des articles.
Pistes pour les éditeurs
Le papier ne donne pas de conseil aux éditeurs. Les pistes qui suivent sont nos déductions, à partir du fonctionnement qu'il décrit.
- Publier vous-même la mise à jour. Sur un sujet qui bouge, l'article qui donne l'issue remplace les autres. Un titre qui énonce le résultat aide le modèle à juger, comme dans le cas des Rangers (« Article A reports on the outcome of that series »).
- Garder un angle précis. Le cas CoreLogic montre qu'un angle précis survit à un article plus récent et plus large, tant que ce dernier laisse de côté votre information.
- Réserver « ce soir » et « cette nuit » aux contenus d'actualité. PTR lit le texte, les images et la vidéo pour estimer une durée de vie. Une formule datée, ou la photo d'un événement terminé, peut ranger l'article parmi les contenus à vie courte.
- Relativiser la promotion maison. PTR apprend sur les clics de recherche, parce que les pages vues sont « biased by publisher promotion ». La mise en avant sur votre page d'accueil, dans vos notifications ou sur vos réseaux échappe donc à ce modèle.
- Éviter la republication. Elle prolonge la visibilité du sujet, mais le journal 1492 la déconseille : Discover rétrograde régulièrement certains sites qui la pratiquent en masse, installés sur d'anciens noms de domaine abandonnés puis repris (des « domaines expirés »).
- Mesurer votre propre courbe, comme le propose le journal 1492. Dans la Search Console, onglet Discover, comparez la courbe journalière de vos dix meilleurs articles de septembre à celle de vos dix meilleurs de février. Si le premier jour est comparable et que la traîne des jours suivants a disparu, vous êtes dans le cas décrit ici.
Méthode et limites
Nos données viennent d'un panel de fils Discover, les flux de nos comptes de test, que nous suivons de mars à octobre 2026, en français et en anglais. L'audience d'un article est le nombre de ses affichages dans ces flux. Un article est une adresse distincte. Une carte est un article affiché dans un fil un jour donné, si bien qu'un même article peut donner plusieurs cartes. Les effectifs changent donc d'une mesure à l'autre. La présence sur plusieurs jours porte sur environ 35 400 articles, vidéos et réseaux sociaux exclus. L'âge à l'affichage ne porte que sur les cartes dont l'adresse contient une date : environ 23 700 sur tout le panel, soit 18 % des cartes, dont environ 15 000 pour les cinq fils suivis chaque mois de la série mensuelle. Le test des formules racoleuses porte sur environ 23 500 articles notés au printemps. Les catégories viennent de motifs de titre ou d'adresse. La langue d'un fil est déduite de ses réglages. La plupart des comparaisons avant-après opposent mai-juin à août-septembre 2026.
Ces données ont des limites. Le panel est petit, surtout en français. Une partie des écarts peut venir de la saison et de l'actualité. Nous ne voyons pas le trafic sur les sites des éditeurs. Les noms que nous donnons aux scores sont nos hypothèses, tirées de leur comportement. Enfin, une coïncidence de dates ne prouve rien : SDF fournit un mécanisme plausible pour la baisse de juillet, sans en démontrer la cause.
Sources :
- Di Bai, Feng Han, Zhenwei Tang, Jintao Liu, Luoshu Wang, Jialu Liu. « Decomposing Staleness in Recommender Systems: A Dual-Filter Framework for Supersession and Decay ». CIKM 2026, Rome. arXiv 2608.15780. DOI 10.1145/3799682.3840082.
- Di Bai, Jintao Liu, Zhenwei Tang, Peifan Wu, Nada Al-Thawr, Luoshu Wang. « Heterogeneous Ranking in Industrial-Scale Recommender Systems: A Case Study ». RecSys 2026. arXiv 2607.27577. DOI 10.1145/3773078.3831848.
- Paul Covington, Jay Adams, Emre Sargin. « Deep Neural Networks for YouTube Recommendations ». RecSys 2016.
- Jianling Wang et al. « Fresh Content Needs More Attention: Multi-funnel Fresh Content Recommendation ». KDD 2023.
- Brevet US7346839 B2, « Information retrieval based on historical data », Acharya et al., Google, délivré le 18 mars 2008.
- Brevet US8972391 B1, « Recent Interest Based Relevance Scoring », McDonnell et al., Google, délivré le 3 mars 2015.
- 1492.vision, Journal de bord Discover du 8 octobre 2026.
- 1492.vision, Les pipelines de Google Discover.
- 1492.vision, En 2026, les cartes Google Discover portent une entité par lecteur, les sujets de Google et de nouveaux signaux related, octobre 2026.
- 1492.vision, Inside Google Discover's New Internal Signals, décembre 2025.
Données et observations : 1492.vision, à partir de l'analyse de vrais flux Google Discover et de la recherche publique disponible. Les mécanismes internes présentés sont nos interprétations ; Google ne les a pas confirmés. Google et Google Discover sont des marques déposées de Google LLC. Nous n'avons aucun lien avec Google.
- Supersession : le fait qu'un contenu plus récent en remplace un autre, en rendant caduque l'information qu'il donnait. ↩
- Entité : personne, organisation, lieu ou notion que Google reconnaît dans un texte, comme « Anthropic », « Tour Eiffel » ou même « Polo converse taille L ». ↩
- Précision : part des articles jugés périmés par le modèle qui le sont vraiment. Rappel : part des articles périmés que le modèle repère. F1 : moyenne des deux (moyenne harmonique). ↩
- Distillation : technique qui consiste à entraîner un petit modèle à reproduire les réponses d'un grand modèle, pour obtenir des résultats proches à un coût bien plus faible. ↩
- Raisonnement explicite (chain of thought) : le modèle écrit les étapes de son raisonnement avant de donner sa réponse. Ici, l'explication est apprise à partir des réponses du grand modèle. ↩
- Inférence en langue naturelle (NLI) : tâche dans laquelle un modèle juge si une phrase en implique une autre, la contredit, ou n'a pas de rapport avec elle. ↩
- PTR (predicted traffic ratio) : part prédite du trafic de vie d'un article, reçue entre sa publication et un horizon donné. ↩
- Fusion précoce : le texte, l'image et la vidéo sont donnés ensemble au même modèle dès l'entrée, au lieu d'être traités séparément puis assemblés (fusion tardive). ↩
- θ (thêta) : seuil de décision. Avec θ = 0,9, l'article est retiré quand la part prédite de son trafic de vie atteint 90 %. ↩
- Amplification : nom que nous donnons à un score attaché à chaque carte, qui semble moduler la diffusion de l'article. Il est le plus souvent positif. Négatif, il signale un article freiné. ↩
- Articles montés et descendus : articles qui reçoivent plus, ou moins, d'affichages dans la variante testée que dans la version de contrôle. ↩
- Groupe témoin (holdback) : part des utilisateurs maintenue sans la fonctionnalité testée, pour mesurer son effet dans la durée. ↩
- Scores de service : nom que nous donnons aux deux scores qui accompagnaient le score de potentiel au printemps 2026. Ils dépendent bien plus que lui du contexte dans lequel l'article est servi. Le premier varie nettement d'un fil à l'autre pour un même article, sans lien mesurable avec la position de la carte ni avec l'amplification. Le second, que nous appelions score de confiance de service, dépend surtout du canal qui recommande l'article : un même article peut obtenir 0,02 dans un canal et 0,96 dans un autre. ↩
Authors
Posted on 2026-10-22
Plus d'infos fiables et sourcées sur Discover ? Ajoutez-nous aux sources !
Ajouter aux sources Ajouter aux sources