En 2026, les cartes Google Discover portent une entité par lecteur, les sujets de Google et de nouveaux signaux related
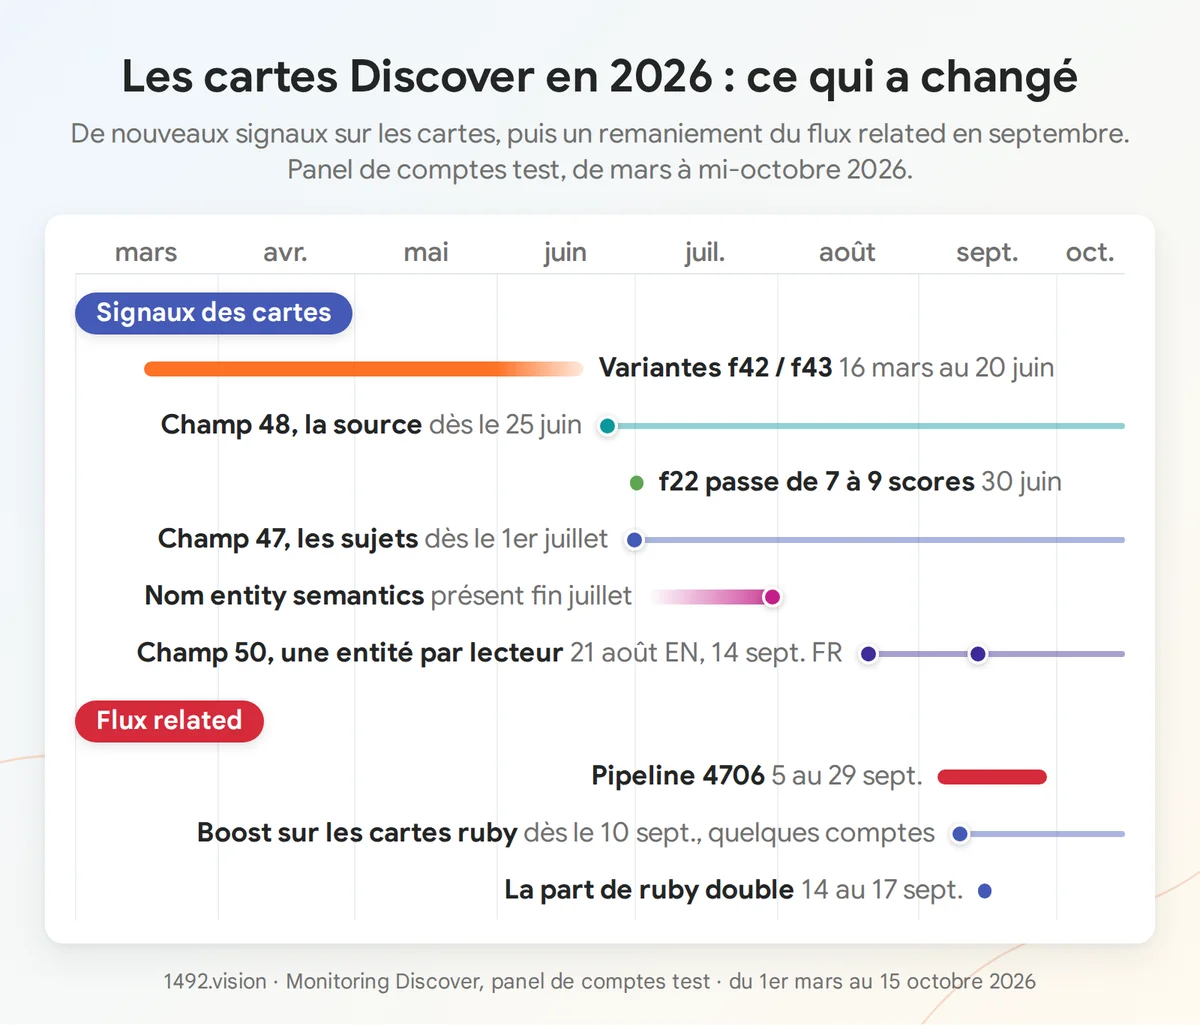
Les changements couverts par cet article, du 1er mars au 15 octobre 2026. Les barres estompées marquent les dates que nous ne pouvons pas fixer.
En décembre 2025, nous avions décrit une première série de nouveaux signaux internes de Google Discover : identifiants d'éditeur, « Multi-Objective Scores », retrieval génératif. Dix mois plus tard, les cartes en portent davantage. Entre mars et octobre 2026, notre monitoring a vu apparaître sur les cartes une entité choisie pour chaque lecteur, la taxonomie publique de sujets de Google arriver sur toutes les cartes, des champs de test apparaître puis disparaître, et le flux related traverser un mois de septembre inhabituel. Les numéros de champ et les indices de score de cet article sont nos propres étiquettes ; les chaînes comme relatedcontentruby sont des noms internes de Google.
Points clés :
-
Depuis le 21 août en anglais et le 14 septembre en français, certaines cartes portent une entité Knowledge Graph choisie pour chaque lecteur (champ 50). Pour un même article le même jour, deux lecteurs reçoivent une entité différente dans 65 % des cas.
-
Cette entité suit l'historique de lecture du lecteur bien plus que ses centres d'intérêt déclarés (63 % contre 4 %), et elle se situe au niveau des entités détaillées que Chrome ne synchronise jamais.
-
Un nouveau nom interne, DISCOVER_PERSONALIZED_ENTITY_SEMANTICS, existait fin juillet, au moins trois semaines avant le champ 50. Selon nous, le nom désigne le côté lecteur, et le champ 50 le côté carte, d'un même appariement.
-
De mi-mars à mi-juin, deux champs (f42 et f43) ont testé des variantes de classement sur un seul compte test, puis ont disparu.
-
Depuis le 1er juillet, les cartes portent jusqu'à cinq sujets de la taxonomie publique de Google (champ 47). Le premier sujet est stable, les derniers changent.
-
En septembre, le flux related a changé de deux façons. Ruby, le pipeline related classique, a gagné du terrain et reçu un boost sur quelques comptes. Un pipeline que nous ne connaissons que par son numéro, 4706, a répondu aux likes et aux see more pendant trois semaines, puis s'est arrêté.
-
Parmi les scores de prédiction f22, f22.8 est devenu le meilleur prédicteur du clic dans notre panel. f22.2, le score le plus lié au boost, est remonté sans mieux prédire les clics.
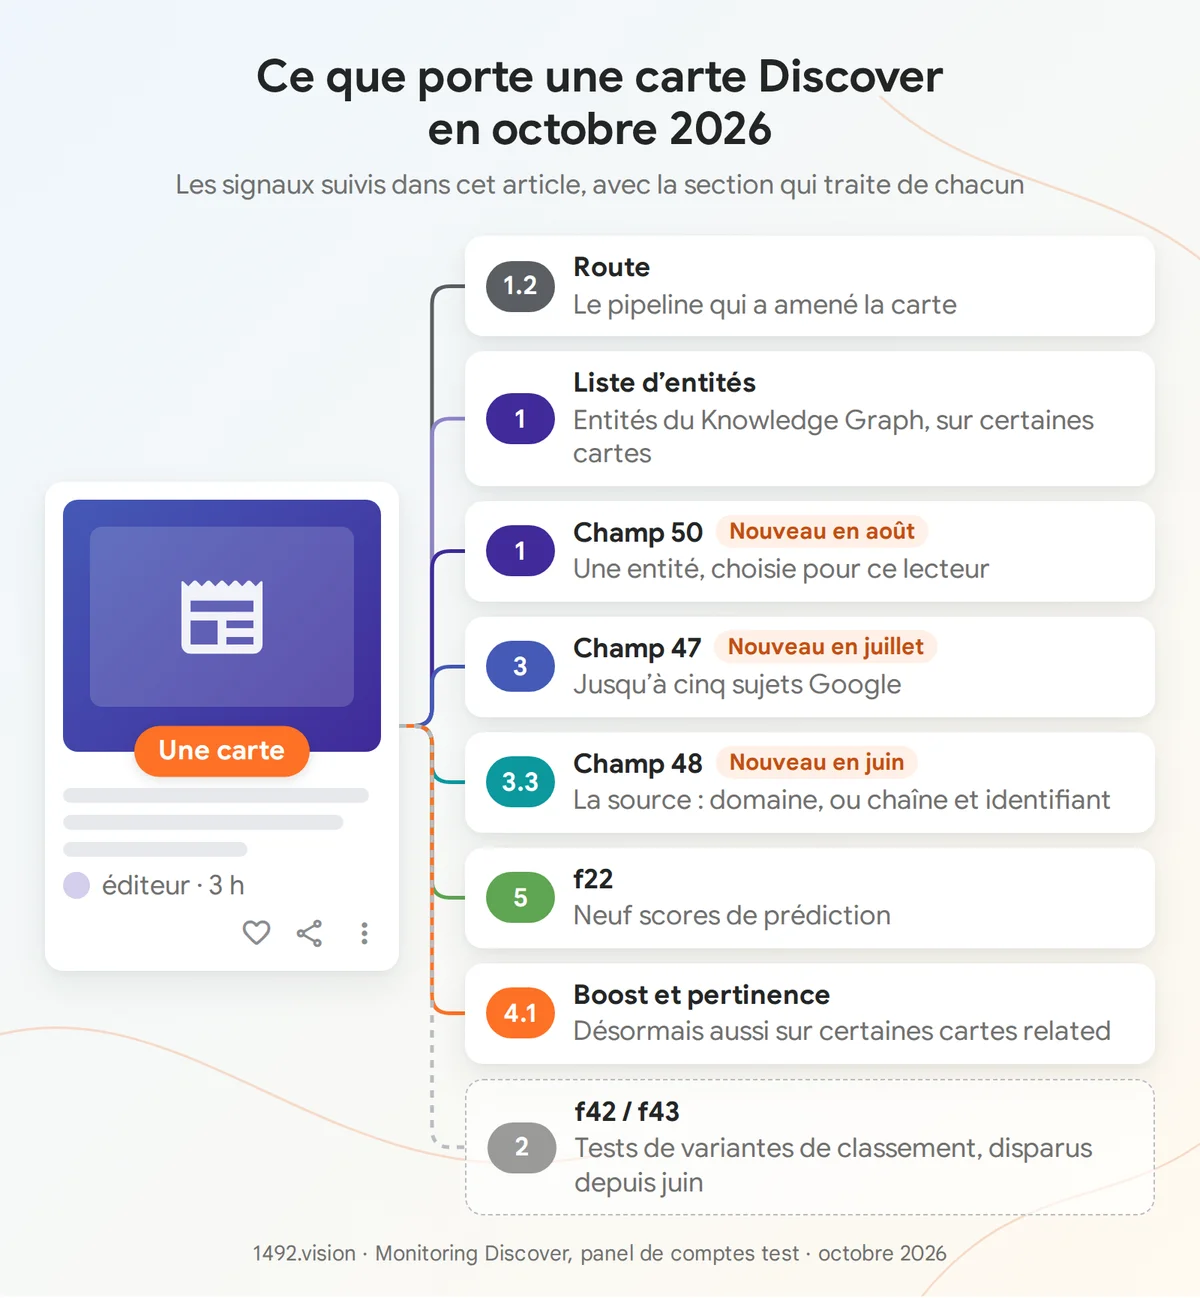
Ce que porte une carte en octobre 2026, avec la section de l'article qui traite chaque signal.
1) Le champ 50 donne à chaque lecteur une entité de l'article
Le champ 50 est apparu le 21 août 2026 sur les cartes en anglais, et le 14 septembre sur les cartes en français. Il contient une seule entité Knowledge Graph, identifiée par son MID, l'identifiant machine du Knowledge Graph. Selon le compte, il figure sur 10 % à 34 % des cartes. 79 % de ces identifiants sont des MID /m/ classiques, 21 % des /g/ plus récents.
Le champ 50 dépend du lecteur. Quand la même URL atteint deux de nos comptes le même jour, le champ 50 diffère dans 65 % des paires en anglais (228 sur 350) et 64 % en français (60 sur 94).
Le 19 septembre, deux de nos lecteurs ont reçu le même article de bleepingcomputer, « Microsoft fixes bug behind 'Defender Antivirus is turned off' alerts ». Le lecteur A a reçu Microsoft (/m/04sv4). Le lecteur B a reçu Microsoft Defender Antivirus (/m/04xd0g). Même jour, mêmes cinq sujets, même source. D'autres paires montrent la même division sur une URL partagée : Google et Gemini, Russie et États-Unis, Avion et Aéronef, Sport et NFL, Linux et Ubuntu.
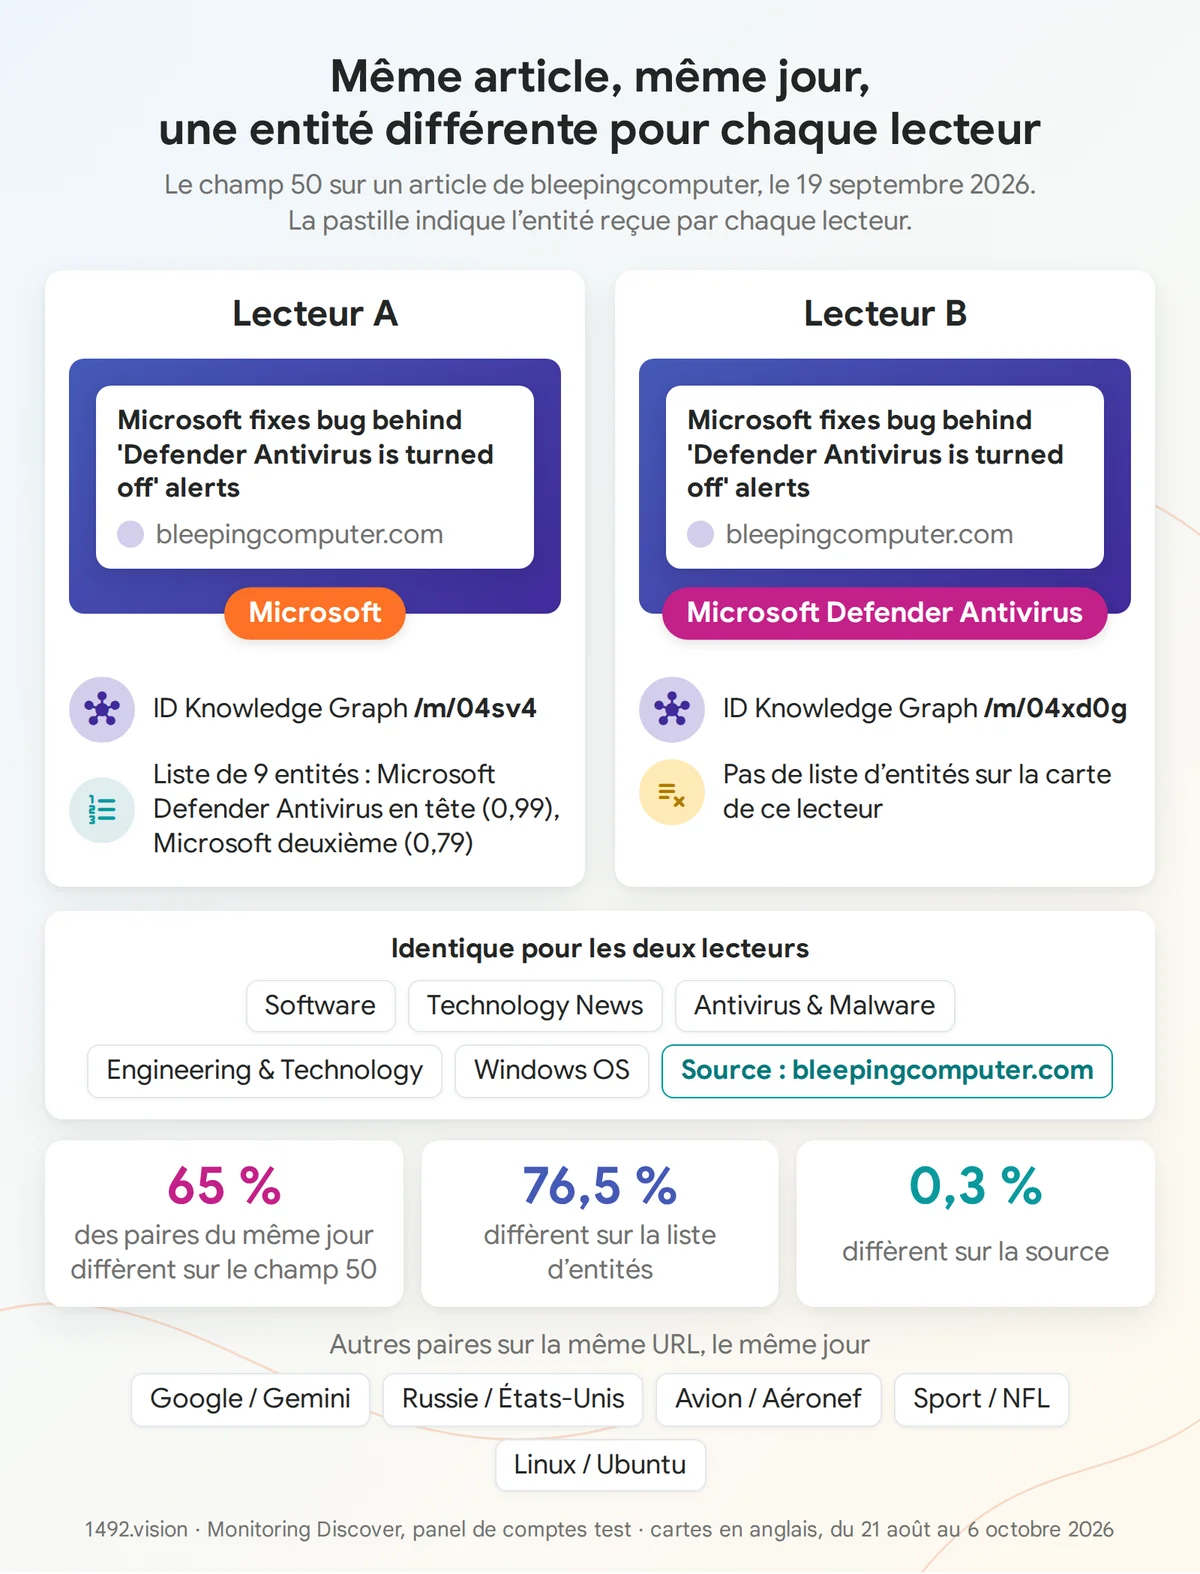
Même article, même jour, deux lecteurs. L'entité change ; les sujets et la source restent les mêmes.
Le champ 50 diffère souvent de l'entité principale de l'article. 75 % des cartes qui le portent n'ont aucune liste d'entités (82 % en français). Quand une liste existe, le champ 50 y figure dans 91 % des cas, mais en première position une fois sur deux environ (49 %). Sur la carte du lecteur A, la liste contient neuf entités, avec Microsoft Defender Antivirus en tête (0,99) et Microsoft deuxième (0,79). Le champ 50 a retenu Microsoft.
Nous avons comparé le champ 50 avec ce que chaque compte test a fait et déclaré. Il correspond à une entité de l'historique de lecture du compte dans 63 % des cas, contre 4 % pour les centres d'intérêt déclarés explicitement. Le champ 50 semble indiquer quelle facette de l'article Google a choisie pour ce lecteur, d'après ce que le lecteur fait.
1.1 Le champ 50 se situe au niveau d'entités que Chrome ne synchronise jamais
Chrome annote les pages visitées à deux niveaux :
-
les entités détaillées, un vocabulaire ouvert de choses précises (Microsoft, OpenAI, Linux, SpaceX, Centre de données) ;
-
les catégories larges, une courte liste de sujets (Logiciels, Sécurité, Films, Technologie).
Seules les catégories larges sont gardées avec l'historique et synchronisées, et seulement quand leur score atteint au moins 85 sur 100. Les entités détaillées ne sont jamais synchronisées.
Le champ 50 se situe au niveau détaillé. Parmi les entités distinctes qu'il a portées sur les cartes en anglais du 21 août au 6 octobre, 94,5 % appartiennent aux entités détaillées et 7 % aux catégories synchronisées (quelques-unes sont les deux).
Google calcule pourtant lui-même ces entités détaillées, et l'URL visitée fait partie de l'historique synchronisé. Nos données ne permettent pas de savoir si Discover lit les données de Chrome. Le champ 50 travaille au même niveau de détail que les entités que Chrome ne synchronise pas.
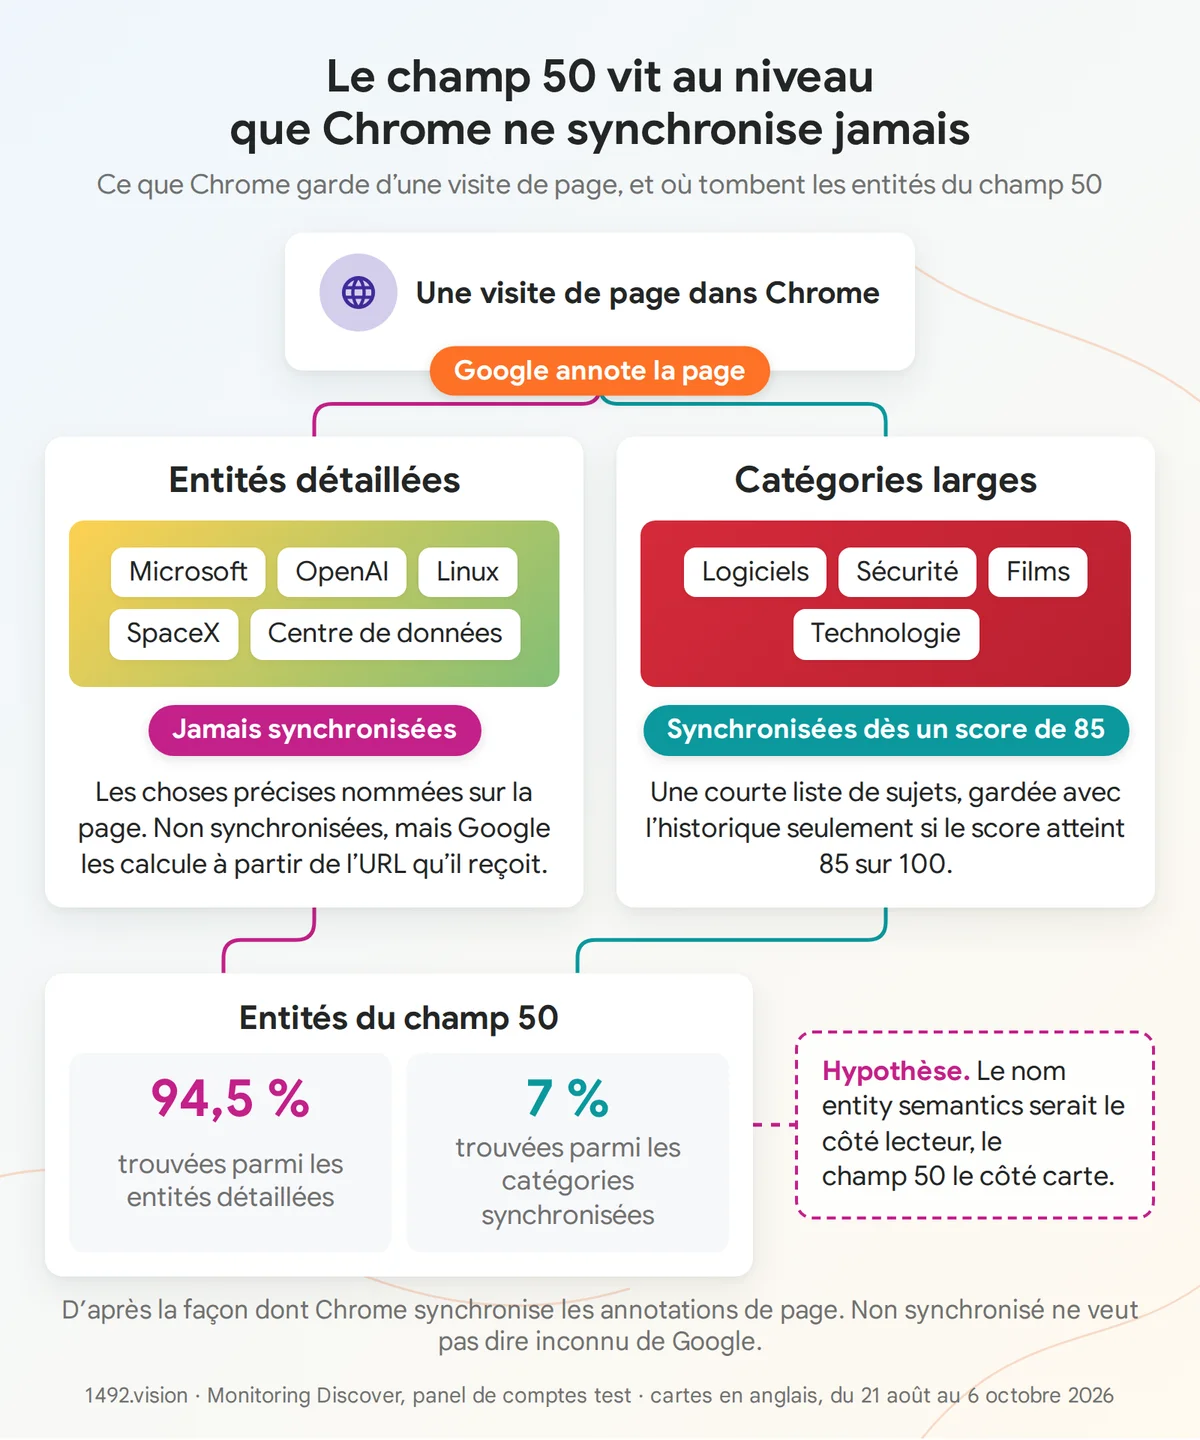
Ce que Chrome garde d'une visite de page, et où tombent les entités du champ 50. Le cadre en pointillés est notre hypothèse (section 1.4).
1.2 Seulement sur les routes qui sélectionnent par sujet
Le champ 50 n'apparaît que sur certaines routes. Sur les cartes en anglais du 13 au 25 septembre, il figure sur toutes les cartes UGC et AIGC, 75 % des vidéos fraîches, 62 % du cluster YouTube, 35 % du flux principal et 11 % des cartes aura. Il n'apparaît jamais sur les cartes related (0 sur 1 246 cartes ruby, 0 sur 567 cartes du pipeline 4706), ni sur les créateurs suivis, le star search, les tendances ou le filtrage collaboratif.
Le champ 50 appartient aux routes qui sélectionnent les cartes par sujet : l'entité serait la raison pour laquelle la carte a été choisie pour ce lecteur. Les routes qui partent d'autre chose (un article qu'on vient de toucher, un créateur suivi, une tendance) ne le portent pas.
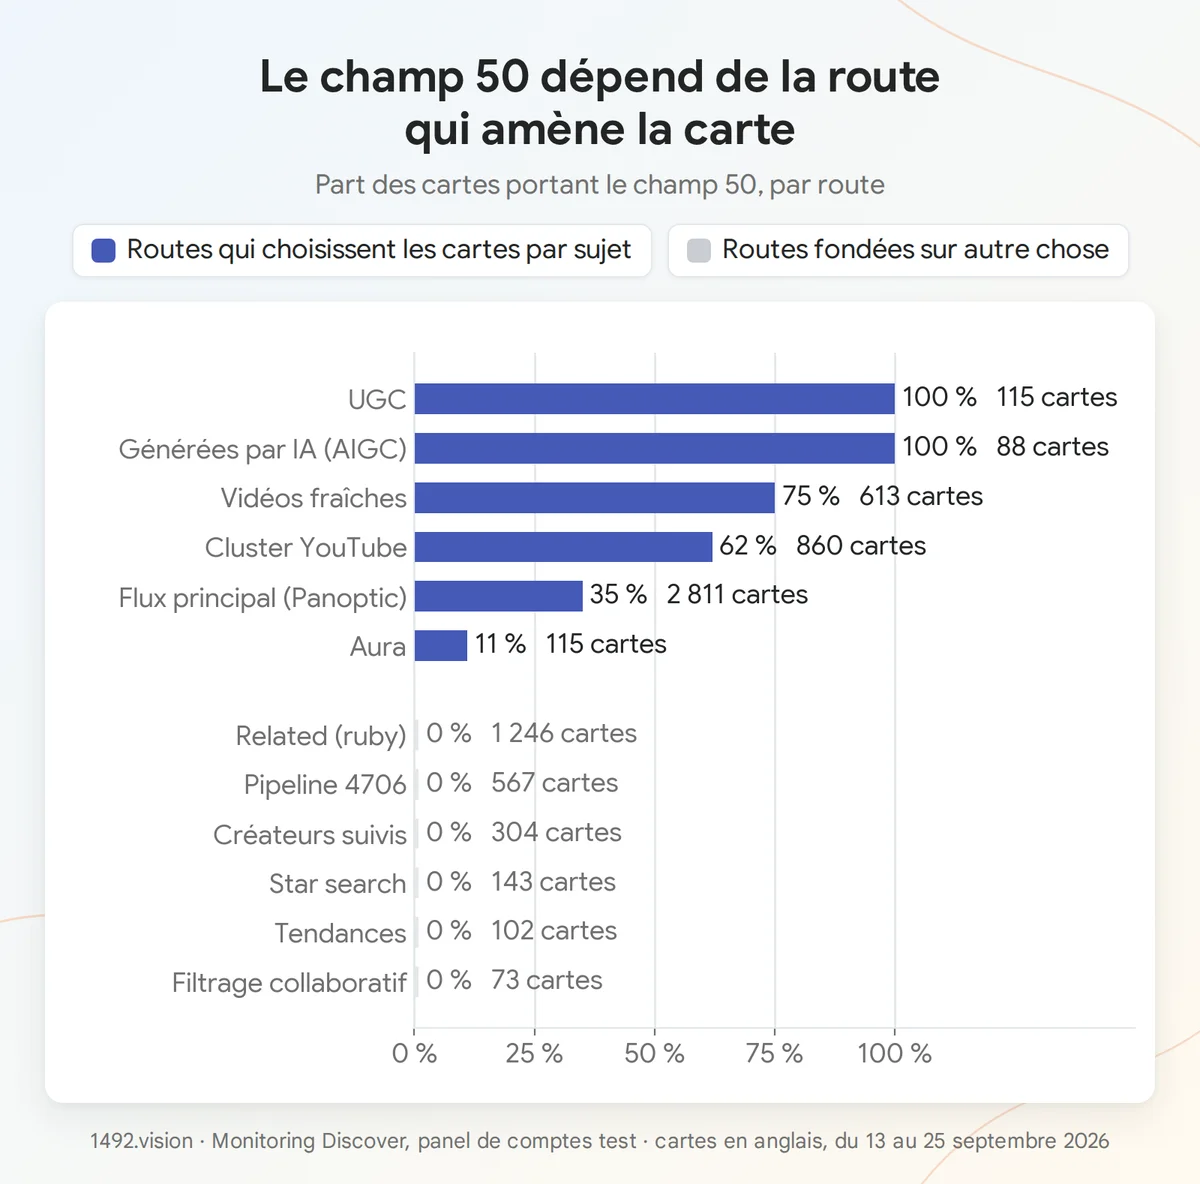
Part des cartes en anglais portant le champ 50, par route, du 13 au 25 septembre 2026.
1.3 Aucun effet mesurable sur le boost
Nous ne voyons aucun effet mesurable du champ 50 sur le boost, la valeur d'ajustement de classement attachée à certaines cartes. Son rôle exact, clé de sélection ou étiquette conservée sur la carte, reste inconnu.
1.4 Un nouveau nom interne est apparu avant le champ 50
Un nouveau nom interne existait fin juillet 2026 au plus tard : DISCOVER_PERSONALIZED_ENTITY_SEMANTICS. Sa date d'arrivée exacte n'est pas connue. Des noms internes plus anciens couvraient déjà les entités : embeddings des entités d'intérêt, historique d'entités, familiarité avec une entité. Nous connaissons le nom et à peu près sa date d'arrivée, mais pas son contenu.
Le nom correspond à ce que nous mesurons sur le champ 50 :
-
DISCOVER : le champ 50 est un signal du flux ;
-
PERSONALIZED : l'entité change d'un lecteur à l'autre dans 65 % des cas ;
-
ENTITY : c'est un identifiant Knowledge Graph ;
-
SEMANTICS : d'un lecteur à l'autre, la facette de l'article change (Google ou Gemini, Sport ou NFL, Linux ou Ubuntu).
La liste d'entités de la carte change aussi avec le lecteur. Pour la même URL le même jour, elle diffère entre lecteurs dans 76,5 % des paires (280 sur 366), contre 13,0 % pour les sujets du champ 47 et 0,3 % pour la source. L'essentiel de la différence entre lecteurs se trouve dans les entités.
Dans le calendrier, le champ 50 arrive le 21 août en anglais et le 14 septembre en français, au moins trois semaines après le nom.
Hypothèse. Le nom interne désignerait le côté lecteur : une représentation, peut-être un embedding, des entités qui comptent pour ce lecteur. Le champ 50 serait le côté carte du même appariement : l'entité retenue pour ce lecteur sur cet article. Cette hypothèse repose uniquement sur une coïncidence de calendrier et de vocabulaire, et la date d'arrivée exacte du nom est inconnue.
2) f42 et f43 ont testé des variantes de classement sur un compte
Du 16 mars 2026 jusqu'à une date située entre le 17 et le 20 juin, deux scores de test de classement que nous appelons f42 et f43 sont apparus sur les cartes Discover. Un seul de nos comptes test les portait, sur 82 % de ses cartes, et les deux champs étaient toujours sur les mêmes cartes.
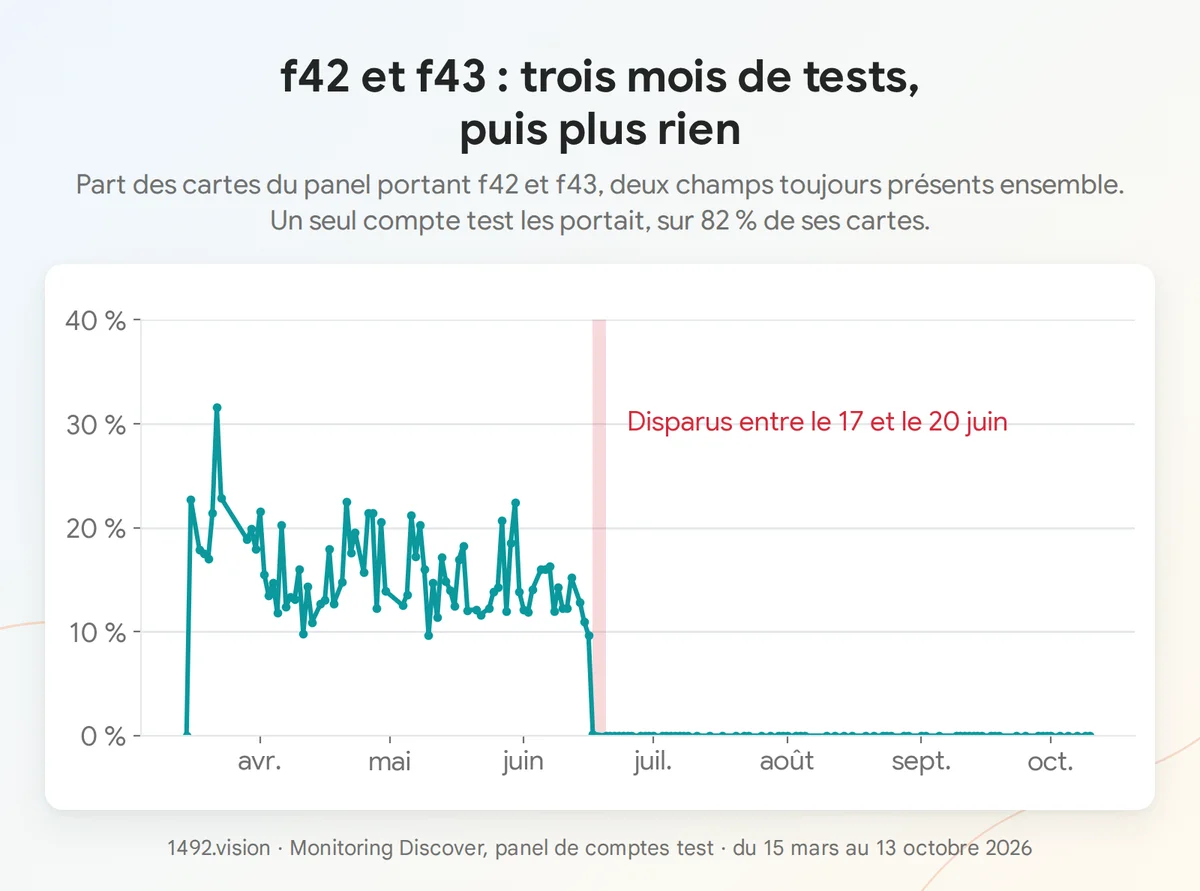
Part de l'ensemble des cartes du panel portant f42 et f43. Un seul compte test les portait, d'où une part faible sur l'ensemble du panel.
Leur valeur a changé dans le temps. Nous avons vu cinq valeurs successives, que nous appelons A à E, chacune avec un boost médian différent, de 0,761 pour A à 1,138 pour B. Certaines ont duré quelques jours (B, du 19 au 23 mars), une a duré deux mois (E, du 15 avril au 17 juin). La plus fréquente, D (du 1er au 15 avril), couvre 2 625 cartes avec un boost médian de 0,835.
Cela ressemble à une expérience de classement : le même compte placé dans des bras de test successifs, parfois superposés, chacun avec son propre effet sur le boost.
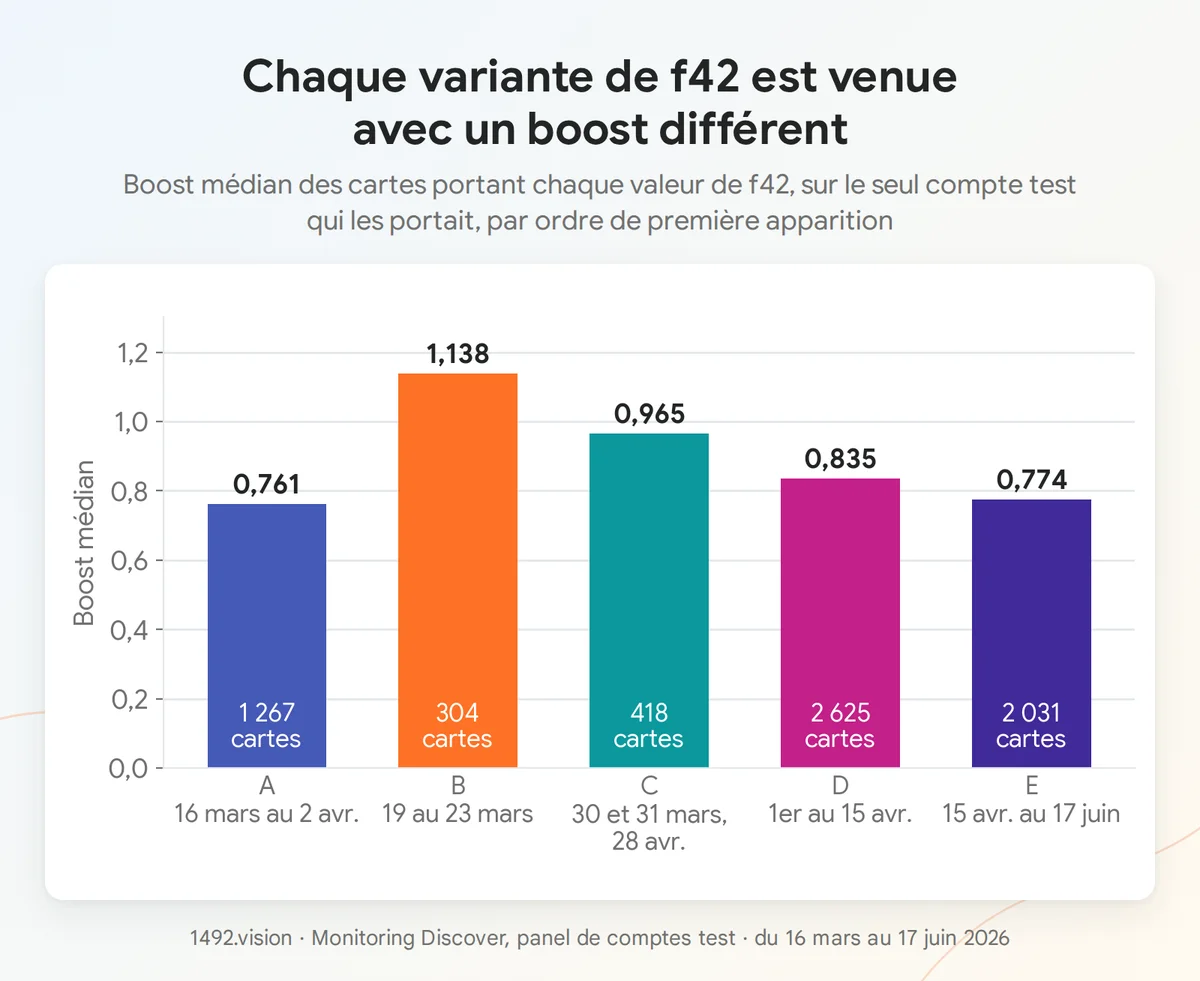
Boost médian des cartes portant chaque valeur de f42, sur le seul compte qui les portait, du 16 mars au 17 juin 2026.
Les champs ont disparu entre le 17 et le 20 juin, environ deux semaines avant l'arrivée du champ 48 (25 juin) et du champ 47 (1er juillet). Ces dates donnent seulement un ordre chronologique : f42 et f43 marquaient des tests sur un compte, alors que les champs 47 et 48 décrivent le contenu de toutes les cartes.
3) Le champ 47 place les sujets de Google sur toutes les cartes
Depuis le 1er juillet 2026, les cartes portent jusqu'à cinq sujets dans un nouveau champ, le champ 47. Du 1er juillet au 13 octobre, nous avons compté 60 030 cartes, 1 440 sujets distincts répartis dans 27 verticales, et 4,86 sujets par carte en moyenne. Une carte peut porter plusieurs verticales à la fois (multi-label).
La taxonomie est celle que Google publie pour Ads, Trends et la Cloud Natural Language API : 97,6 % des sujets que nous voyons ont un nom dans ces listes publiques. Une verticale, 397, manque dans les listes publiques d'Ads et de Trends. La Natural Language API classe les mêmes articles sous Sensitive Subjects (War & Conflict, Death & Tragedy, Accidents & Disasters). Elle figure sur 6,3 % des cartes (3 785).
Dans notre panel, News arrive en tête (55,3 % des cartes), suivie d'Arts & Entertainment (36,3 %), Computers & Electronics (25,3 %), Business & Industrial (23,5 %), Science (18,5 %), Law & Government (15,0 %) et Sports (13,0 %). Cette répartition reflète les centres d'intérêt de nos comptes test.
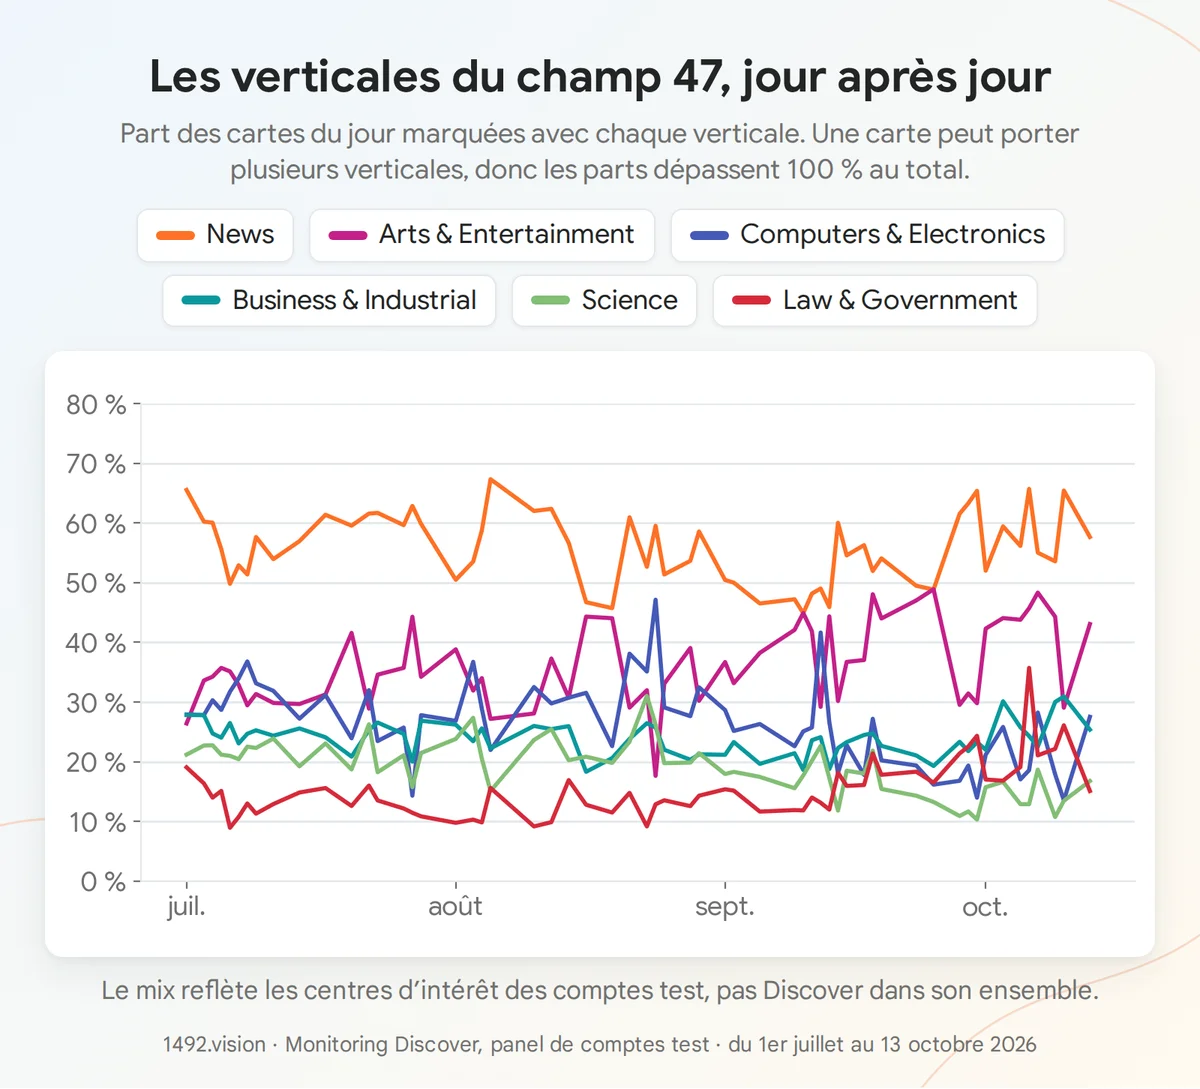
Part des cartes du jour marquées de chaque verticale. Une carte peut en porter plusieurs, donc les parts dépassent 100 % au total.
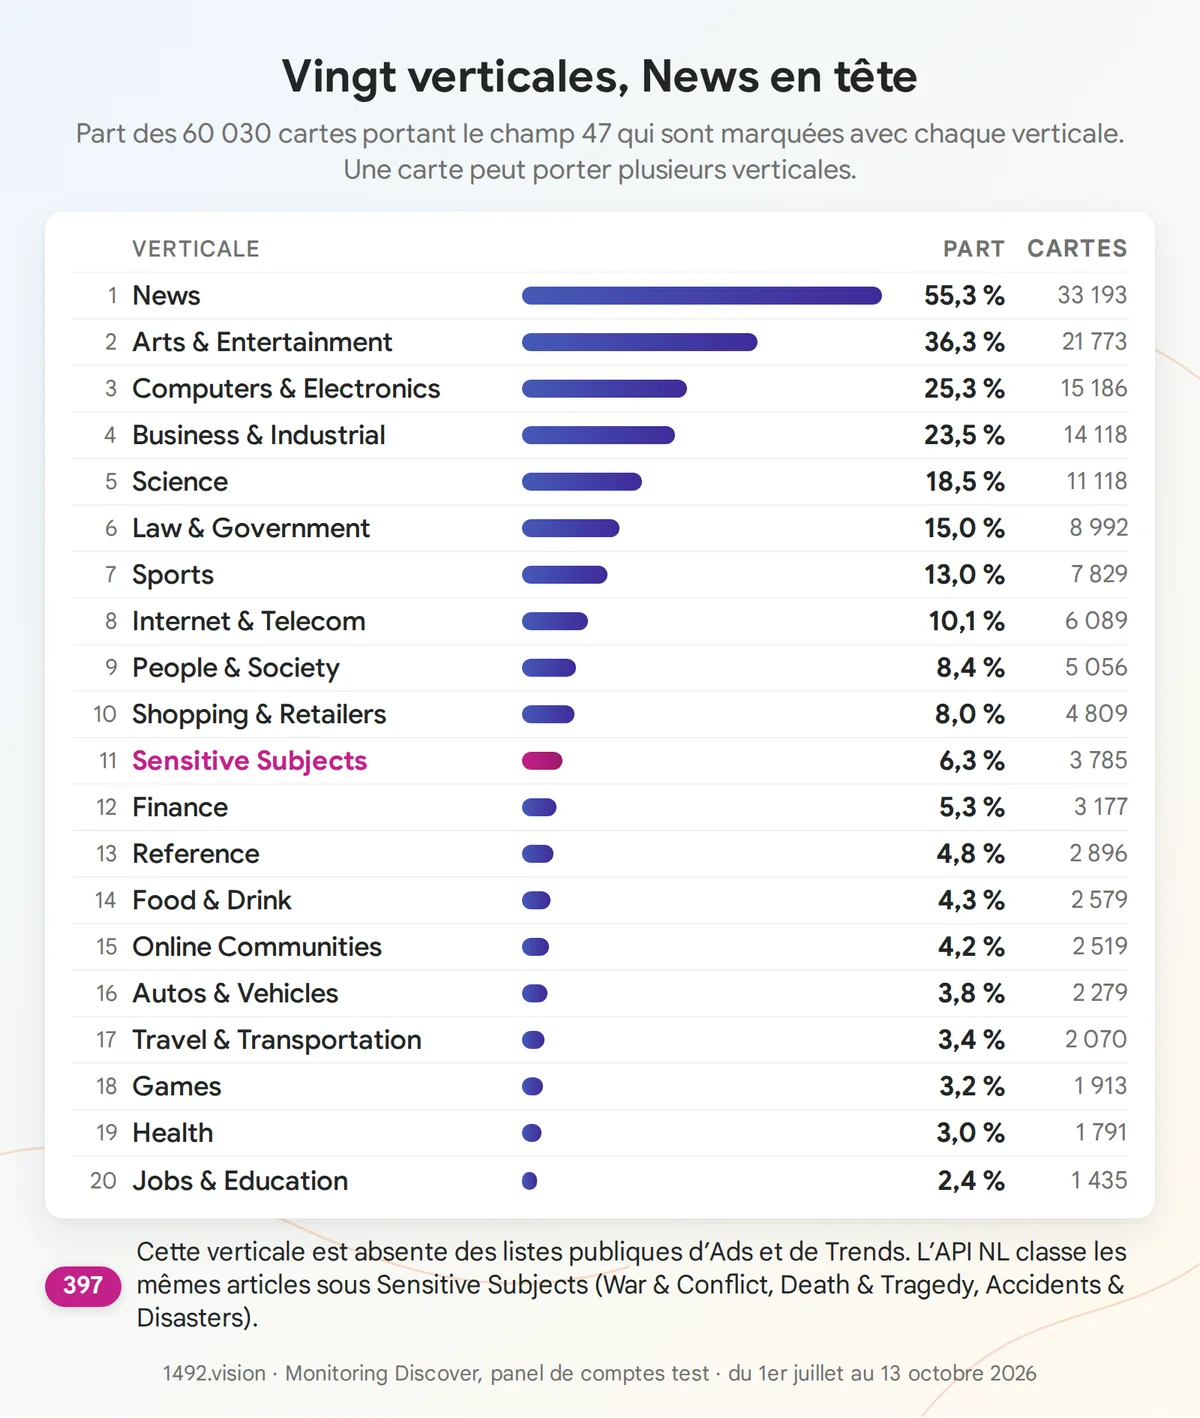
Les vingt verticales les plus fréquentes, du 1er juillet au 13 octobre 2026.
3.1 Les rangs 4 et 5 changent avec le temps
Pour une URL donnée, la liste est surtout stable. Sur 14 899 URL vues au moins deux fois, 92,1 % gardent la même liste de sujets et 97,0 % le même premier sujet.
Environ 65 % des changements remplacent un seul sujet, et environ 64 % des sujets remplacés sont au rang 4 ou 5. 60,4 % des sujets qui tournent restent dans l'une des verticales stables de l'URL.
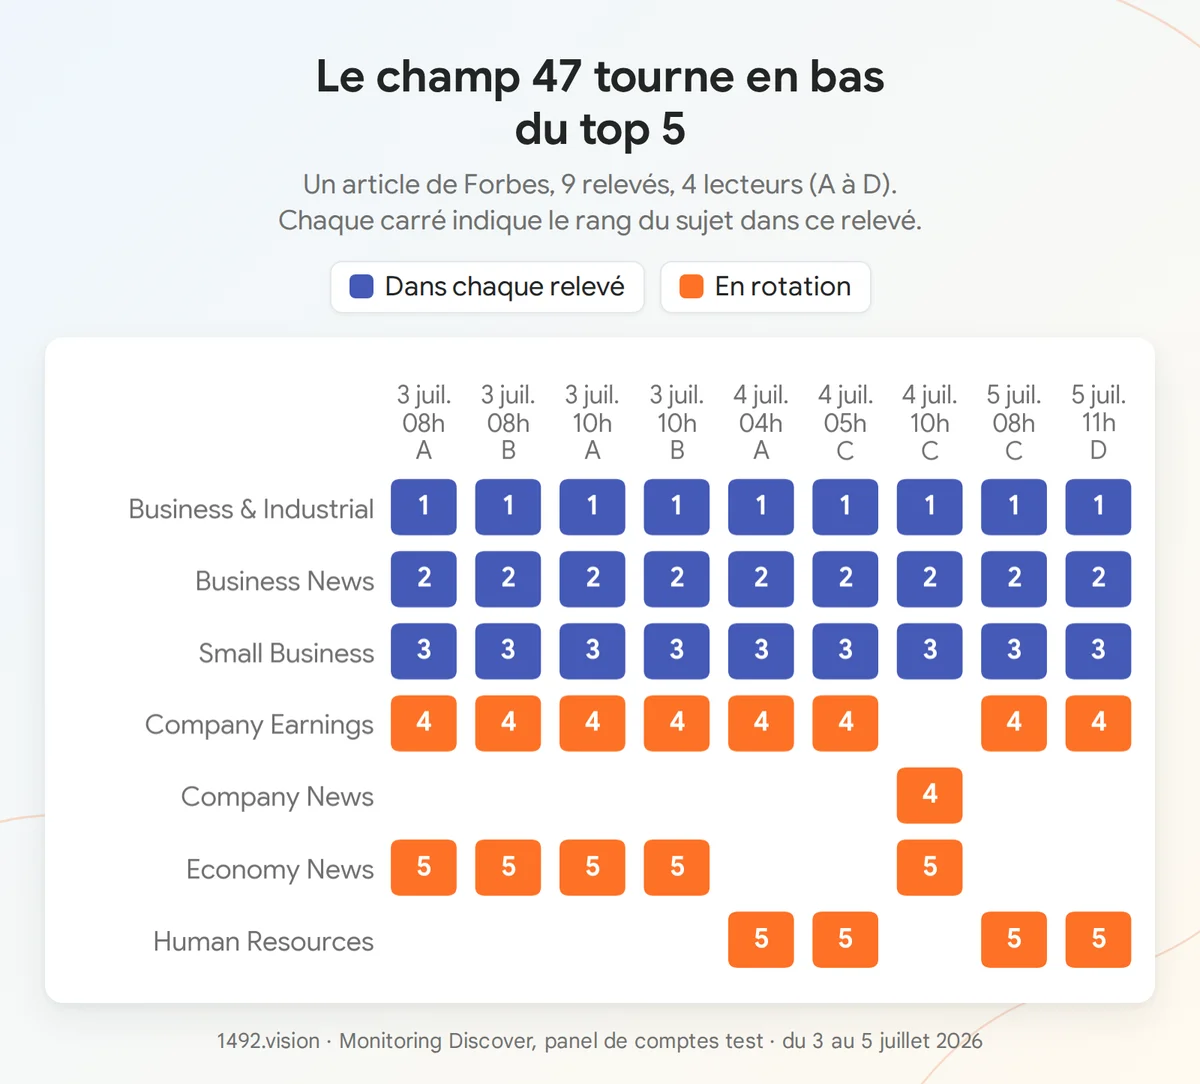
Un article de Forbes, neuf relevés, quatre lecteurs. Les rangs 1 à 3 restent les mêmes ; les rangs 4 et 5 tournent. Economy News le 3 juillet, Human Resources dans la plupart des relevés suivants, quel que soit le lecteur.
Sur quelques URL, la liste passe par beaucoup de sujets. Un article de Reuters sur le gouvernement de la ville de Berlin a reçu 13 sujets différents sur quatre relevés et trois lecteurs, sans qu'aucun sujet soit présent dans tous. Des articles de bfmtv, androidpolice et cnbc atteignent 10 ou 11.
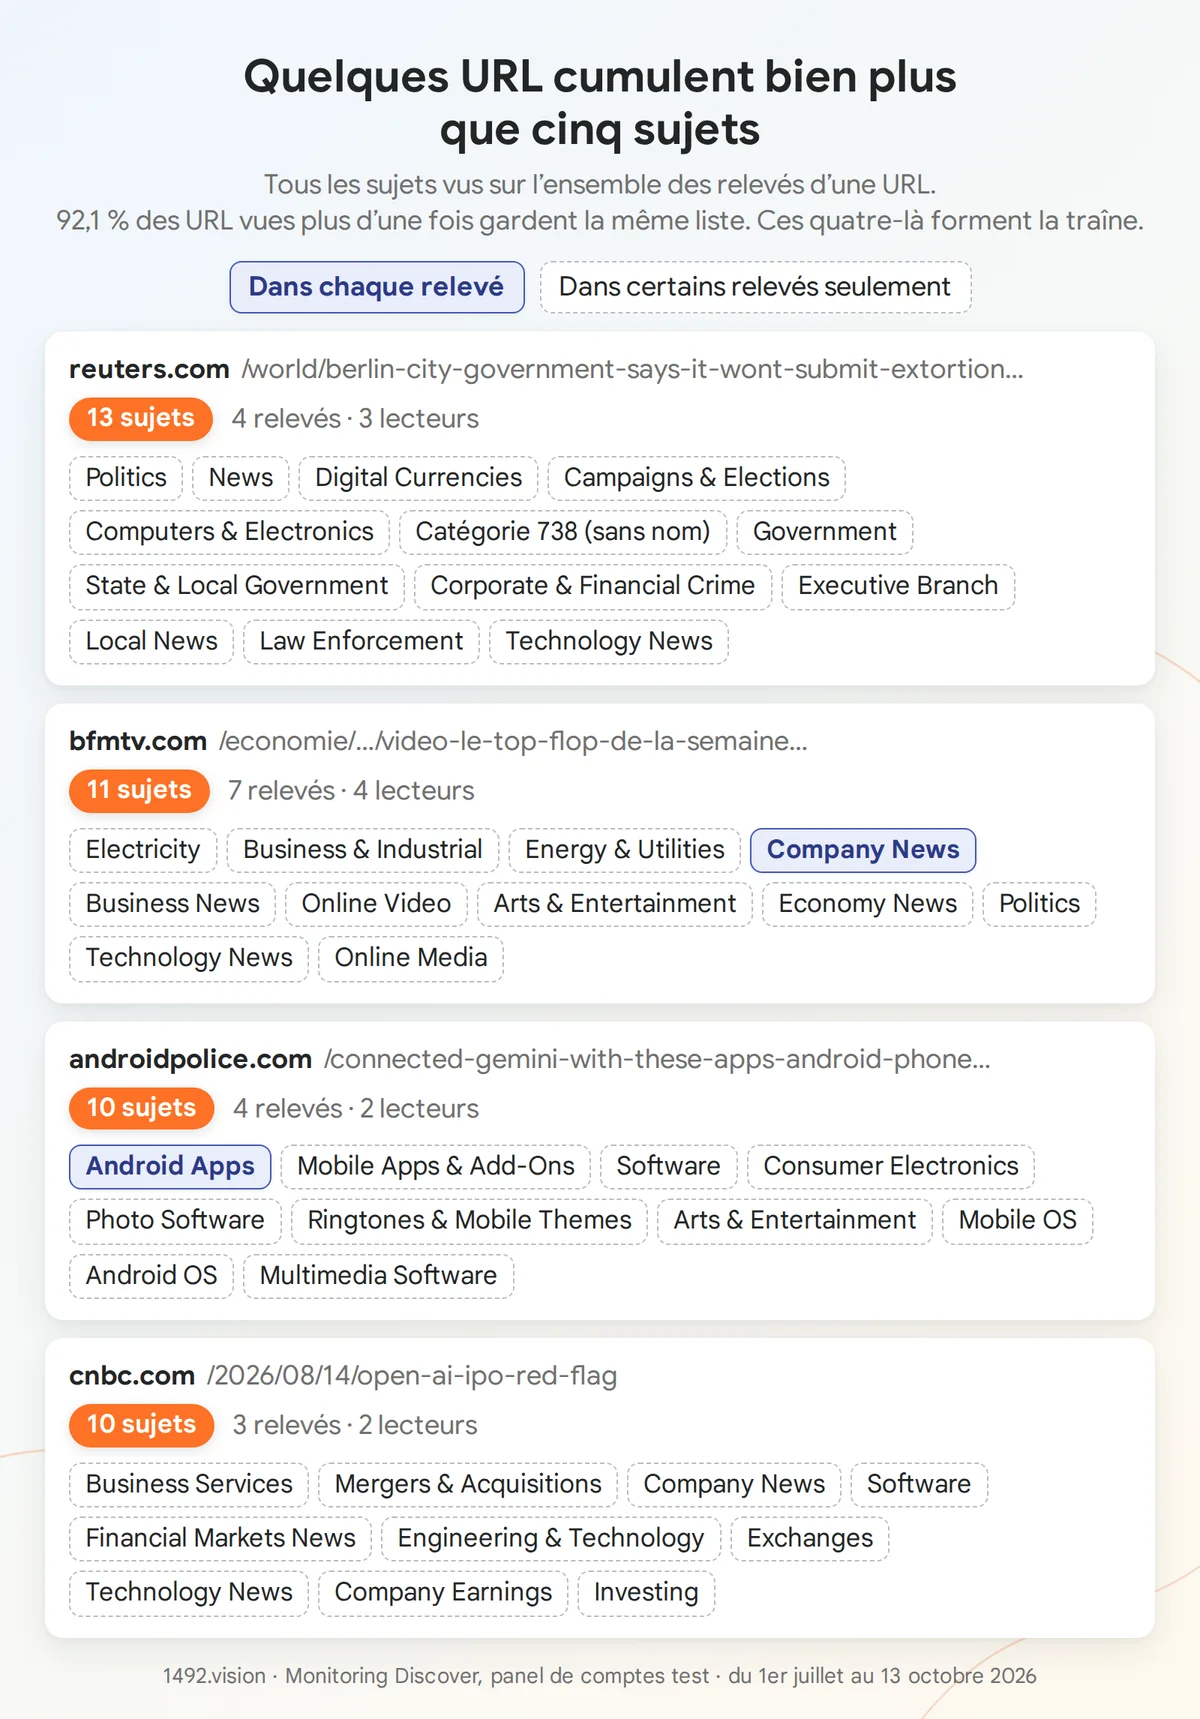
Tous les sujets vus sur les relevés de quatre URL. Trait plein : dans chaque relevé. Pointillés : dans certains seulement.
La rotation suit le temps plus que le lecteur. Part des paires de relevés d'une même URL dont la liste de sujets diffère :
| Paire de relevés | Même lecteur | Deux lecteurs |
|---|---|---|
| Même jour | 5,1 % | 14,2 % |
| Dans la même heure | 8 % | |
| À quatre heures d'écart ou plus | 17 % | 22 % |
La liste semble dériver avec le temps autour d'un seuil, avec au plus un faible effet lecteur. Sur l'article de Forbes ci-dessus, les lecteurs A et B ont tous deux Economy News au rang 5 le 3 juillet, et les relevés suivants montrent surtout Human Resources, pour les lecteurs A, C et D.
3.2 Le champ 47 comparé à la Natural Language API
Nous avons comparé le champ 47 avec ce que renvoie la Cloud Natural Language API (V2) de Google pour les mêmes 218 articles. Les deux utilisent la même taxonomie, avec des classifieurs différents. Sur les verticales :
- similarité de Jaccard : 0,59 ;
- part des verticales du champ 47 aussi renvoyées par l'API : 78 % ;
- part des verticales de l'API couvertes par le champ 47 : 70 % ;
- même première verticale : 38 % des cas.
L'API penche vers les verticales éditoriales et méta (News, Reference, Shopping), le champ 47 vers les verticales de fond (Arts & Entertainment, Science, Business). Pour un éditeur, passer un article dans l'API donne une idée correcte de ses verticales, beaucoup moins des sujets exacts que Discover y attache.
3.3 Le champ 48 identifie la source
Le champ 48 est arrivé le 25 juin. Il identifie la source : le domaine pour un site web, la chaîne et le handle sur une plateforme. Il figure sur 93,8 % des cartes et ne change presque jamais entre lecteurs (0,3 % des paires du même jour).
Nous n'avons pas encore mesuré si le champ 47 intervient dans le classement.
4) Deux pipelines related ont changé en septembre
En février, nous écrivions que les likes ne semblaient plus déclencher d'articles related. Nos données de septembre nous ont permis de le tester à nouveau.
Notre logbook du 22 septembre a mesuré la part de relatedcontentruby, le pipeline related classique que nous appelons ruby, parmi les cartes article dans cinq langues. Pendant l'été, elle se situait entre 13 % et 15 %. À partir du 14 septembre elle a augmenté, et le 17 septembre elle atteignait 24 % à 28 % selon la langue. Elle a gagné 8 à 13 points partout, pris surtout sur le flux principal et la route aura. Notre panel de comptes test montre la même hausse.
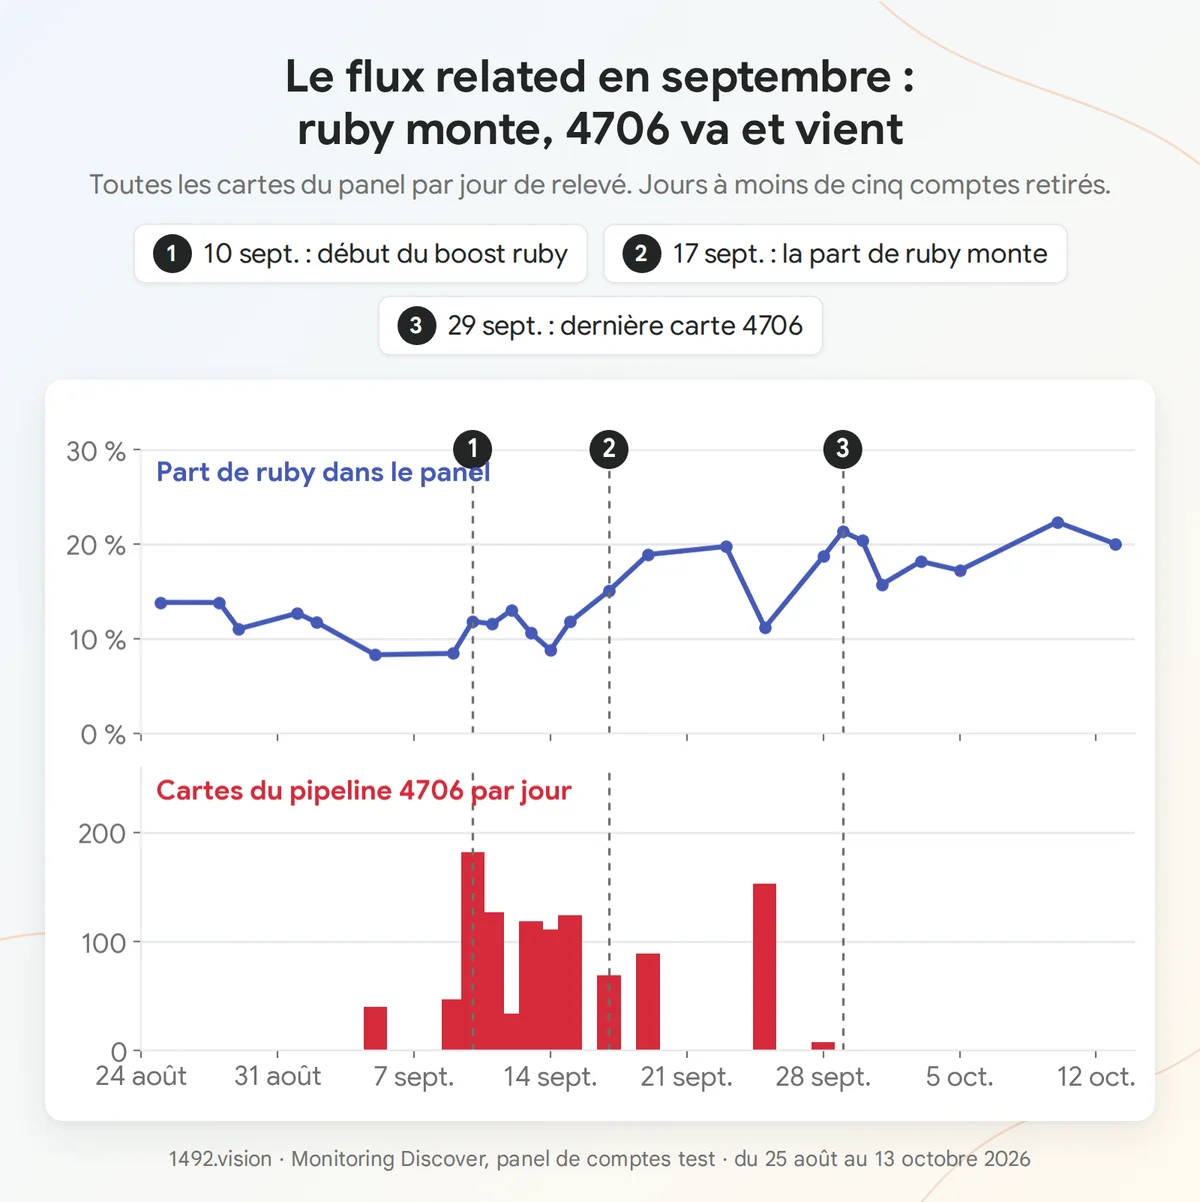
En haut : part de ruby dans l'ensemble des cartes du panel, par jour. En bas : cartes du pipeline 4706 par jour, jusqu'à la dernière le 29 septembre.
Le 19 septembre, ruby représentait 18,9 % de l'ensemble des cartes du panel et le pipeline 4706 4,7 % de plus : 23,6 % du flux venait de ces deux pipelines related.
4.1 Ruby démarre toujours après un clic
Ruby ne démarre qu'après un clic. Environ la moitié des clics sont suivis de cartes ruby dans les 10 minutes (51 % du 22 au 29 septembre, 55 % du 30 septembre au 7 octobre), avec un délai médian d'environ une minute. Les likes et les see more seuls n'en produisent aucune : 0 sur 3 026 likes et 0 sur 682 see more du 22 au 29 septembre, puis 0 sur 2 433 et 0 sur 376 du 30 septembre au 7 octobre. Un test contrôlé le 7 octobre, avec un seul geste par article, a donné le même résultat.
La hausse de septembre a allongé les listes : de 1,48 à 1,50 article distinct par seed avant mi-septembre à 2,27 du 17 septembre au 13 octobre. Les seeds suivis d'une seule carte sont passés de plus de la moitié (54 % à 58 %) à 34 %.
Après qu'un lecteur a ouvert un article sur le nucléaire, les cartes related se sont réparties en deux groupes. Quatorze venaient d'autres sites (Le Figaro, BFM TV, Reporterre, La Voix du Nord et d'autres) et portaient les entités Knowledge Graph du seed : Centrale nucléaire, Réacteur nucléaire, Électricité. Vingt et une autres venaient du site du seed, sur des sujets sans rapport. Un ensemble related se construit donc en partie à partir du sujet et des entités du seed, en partie à partir de sa source. La part de recirculation d'un site vers ses propres articles varie beaucoup : Le Parisien, par exemple, n'occupe qu'environ 3 % des places related qu'il génère comme seed.
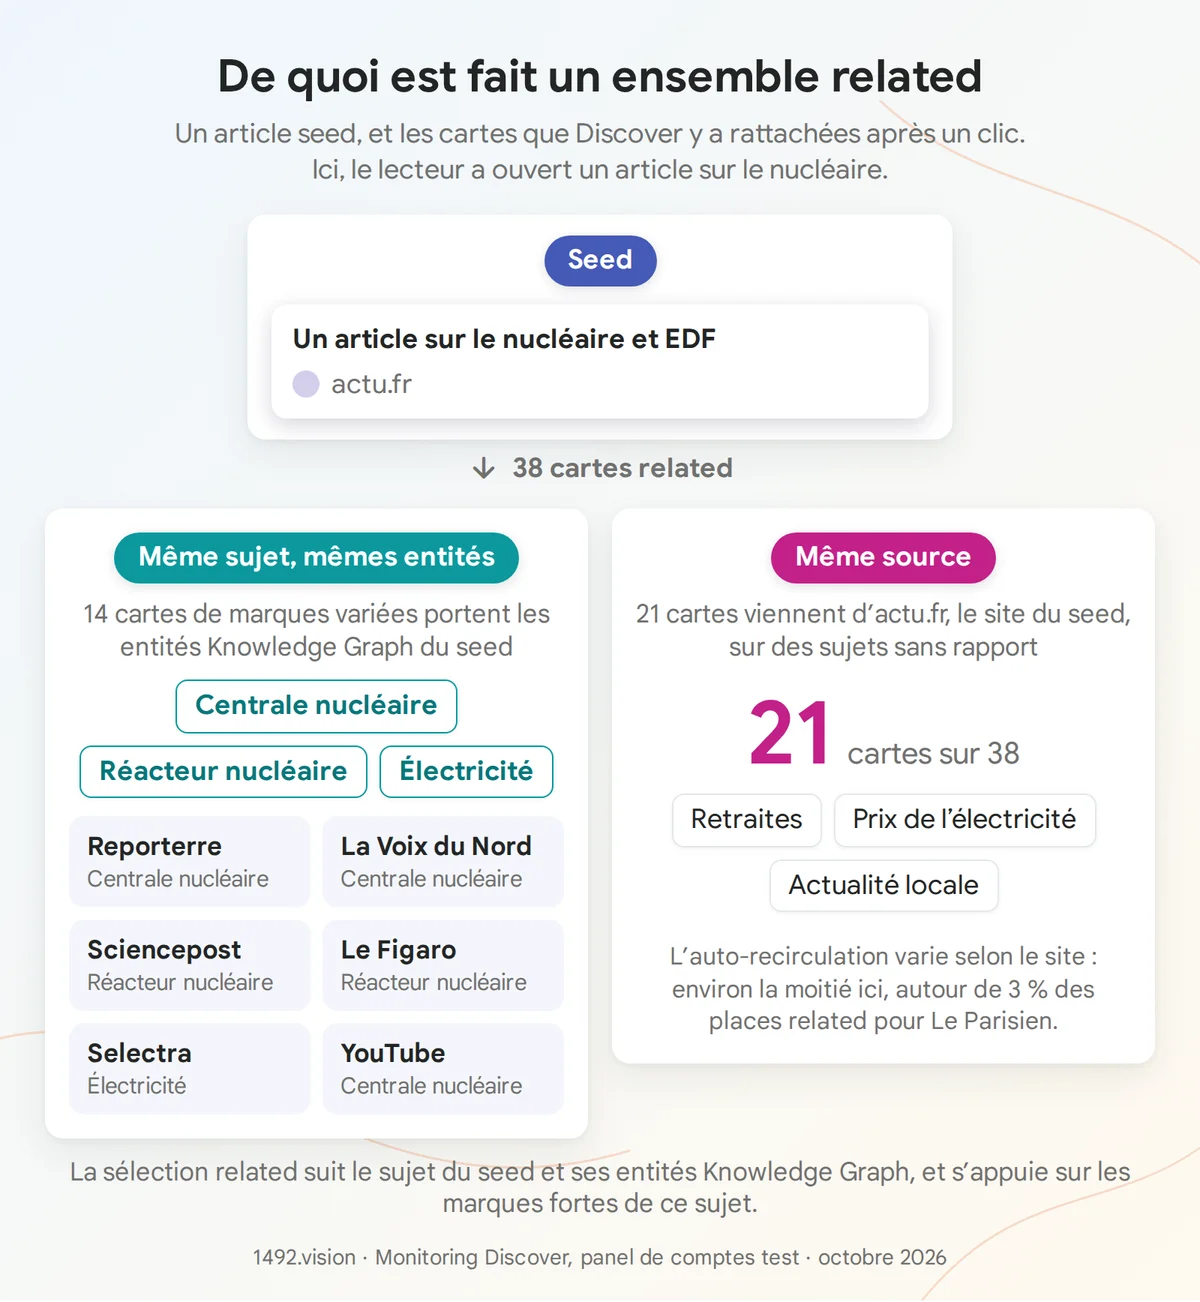
Un seed et son ensemble related. Les cartes partagent soit le sujet et les entités Knowledge Graph du seed, soit sa source.
Depuis le 10 septembre, les cartes ruby reçoivent aussi un boost et un score de pertinence sur un petit groupe de comptes test (quatre, jamais plus de trois le même jour), où 71 % à 100 % des cartes ruby sont boostées. Nous n'avions jamais vu de boost sur ruby de mars à août.
Le boost va de -8,45 à +4,59 : il peut faire monter ou descendre une carte related. Sur la même période, le boost médian de ruby est de 0,45, contre 1,06 pour toutes les autres cartes boostées. Les autres routes ont aussi des boosts négatifs (7,2 % de leurs cartes boostées, contre 12,4 % pour ruby) : le signe négatif n'est donc pas propre à ruby. Le boost était toujours présent en octobre, avec 107 cartes ruby boostées le 10 octobre.
Les cartes ruby portent aussi moins d'entités qu'avant : 79 % avaient une liste d'entités en juin, 55 % à 57 % en septembre et octobre.
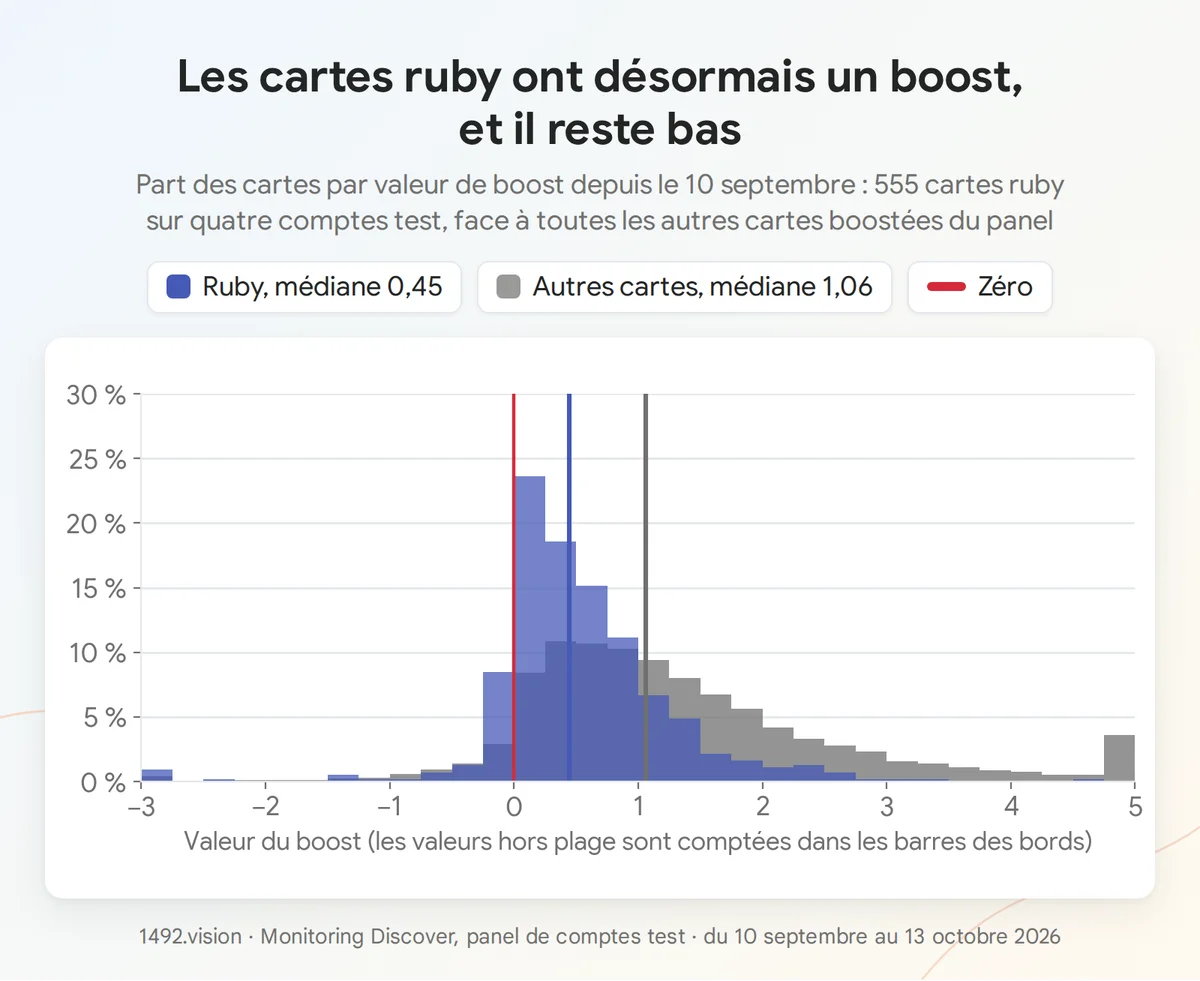
Part des cartes par valeur de boost, du 10 septembre au 13 octobre 2026 : cartes ruby contre toutes les autres cartes boostées du panel.
4.2 Le pipeline 4706 a fonctionné du 5 au 29 septembre
Du 5 au 29 septembre, un second pipeline related a servi des cartes dans notre panel. Nous ne le connaissons que par son numéro, 4706. Sa catégorie de carte, ses déclencheurs et son format diffèrent tous de ceux de ruby.
Sur 1 032 cartes du 22 au 29 septembre, le déclencheur était un like pour 37 % d'entre elles, un see more pour 36 % et un clic pour 17 %. Les likes et les see more, qui n'ouvrent jamais ruby, ont bien ouvert des cartes 4706.
La carte arrive seule, une à deux secondes après le geste, insérée dans le flux déjà chargé. Sa position varie. Après un clic sur un article de CNN, un post X apparaît juste sous cet article. Après un see more sur une vidéo du Fantastic Fest, une bande-annonce de film apparaît plusieurs cartes plus bas, entre deux cartes déjà présentes.
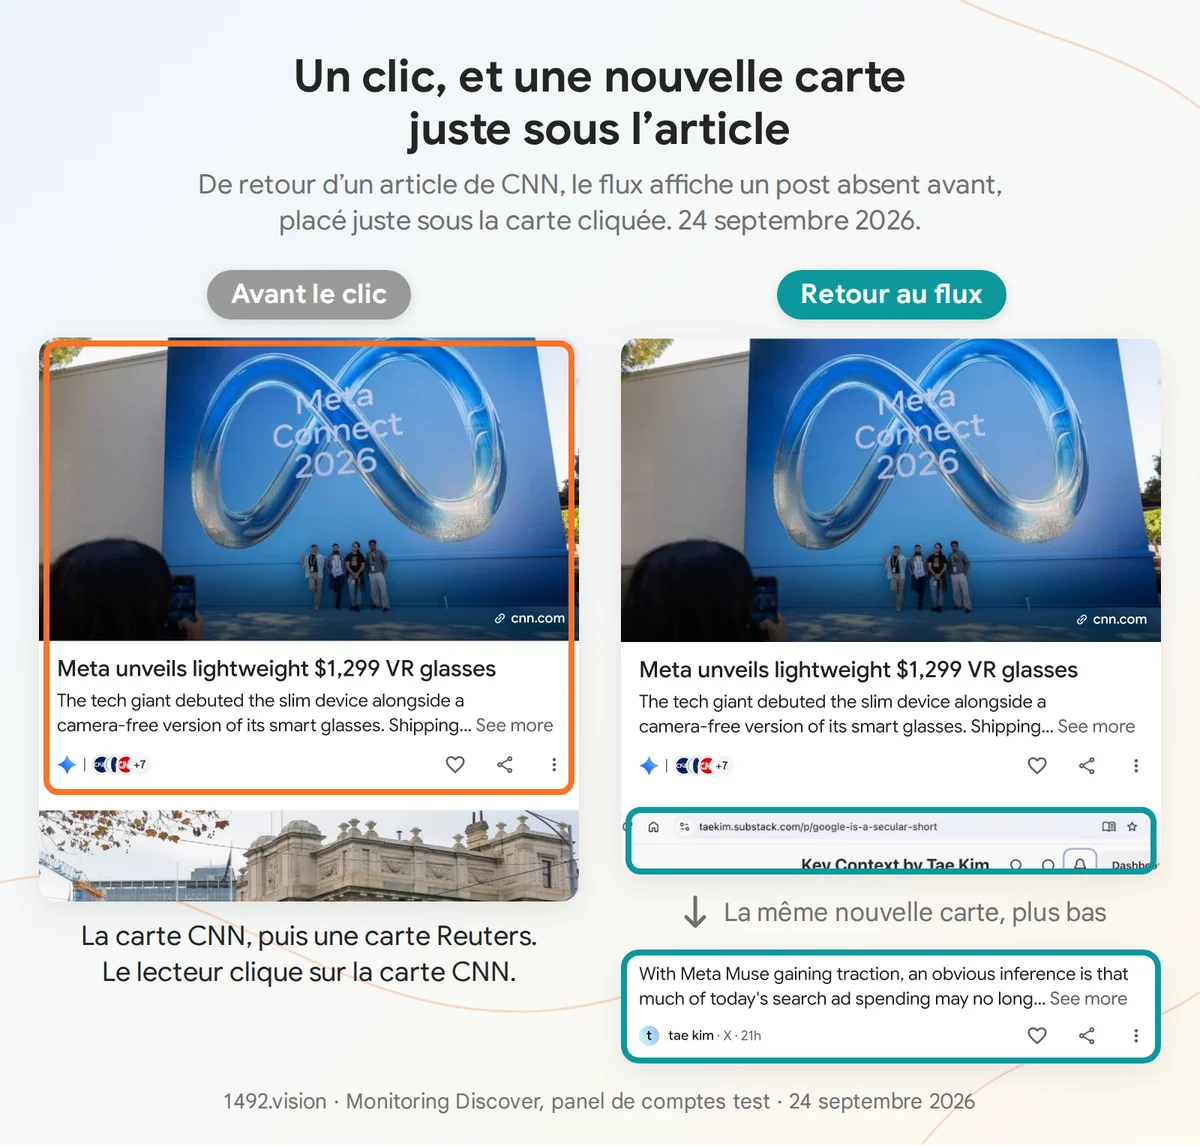
Au retour d'un article de CNN, un post absent jusque-là se place juste sous la carte cliquée. 24 septembre 2026.
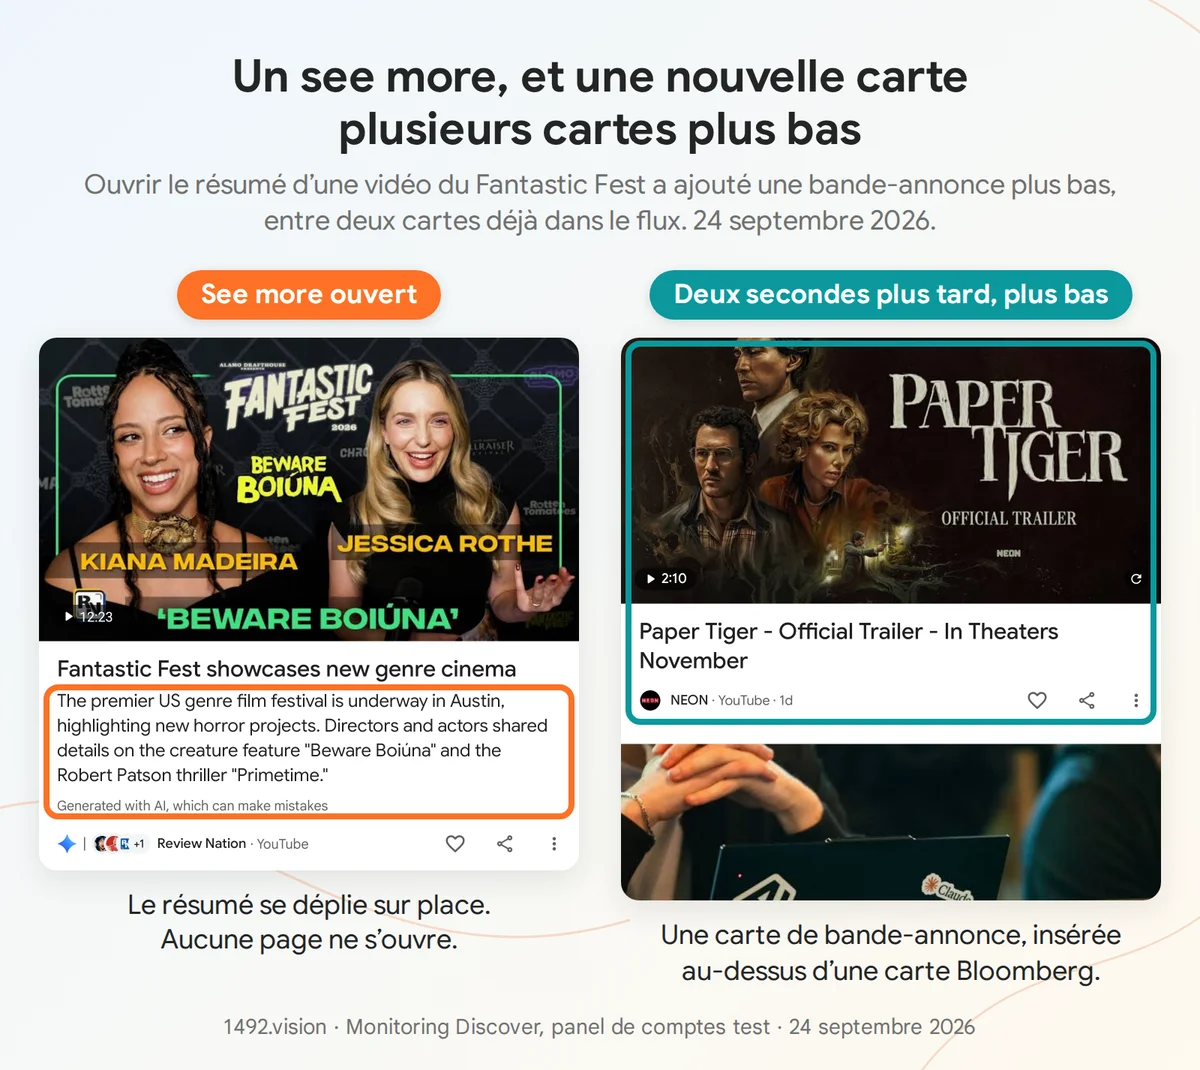
Un see more déplie le résumé sur place. Deux secondes plus tard, une carte bande-annonce apparaît plus bas, au-dessus d'une carte Bloomberg. 24 septembre 2026.
Un geste n'était suivi d'une carte 4706 qu'une partie du temps. Le 25 septembre, 77 % des see more (118 sur 154) ont été suivis d'une carte 4706 dans les 30 secondes, ainsi que 57 % des clics (146 sur 257) et 34 % des likes (390 sur 1 145).
Le pipeline donne une carte par seed (pour 95 % des seeds), contre 1,8 pour ruby sur les mêmes semaines. 34,5 % de ses cartes sont des posts X ou Threads, contre 11,5 % pour ruby, et 83 % de ces posts suivent un article de presse. Le format suit parfois la carte touchée (une vidéo, puis une bande-annonce) et parfois non (un article, puis un post X).
La carte ne porte ni entités, ni boost, ni score de pertinence ; elle porte les prédictions f22 et les sujets du champ 47. Sur les 37 cartes qui permettent le test, sa sélection suit les centres d'intérêt du lecteur au moins autant que le reste du flux. Cet échantillon est trop petit pour aller plus loin.
Le pipeline s'est arrêté en cinq jours. La part des see more suivis d'une carte est passée de 85 % le 22 septembre à 76 % et 77 % les 24 et 25 septembre, 37 % le 26 septembre et 1 % le 27 septembre. La dernière carte que nous avons vue est arrivée le 29 septembre, et aucun compte n'en a reçu jusqu'au 15 octobre. Un arrêt qui touche tous les comptes en même temps indique une décision côté Google. Nous n'en connaissons pas la raison.
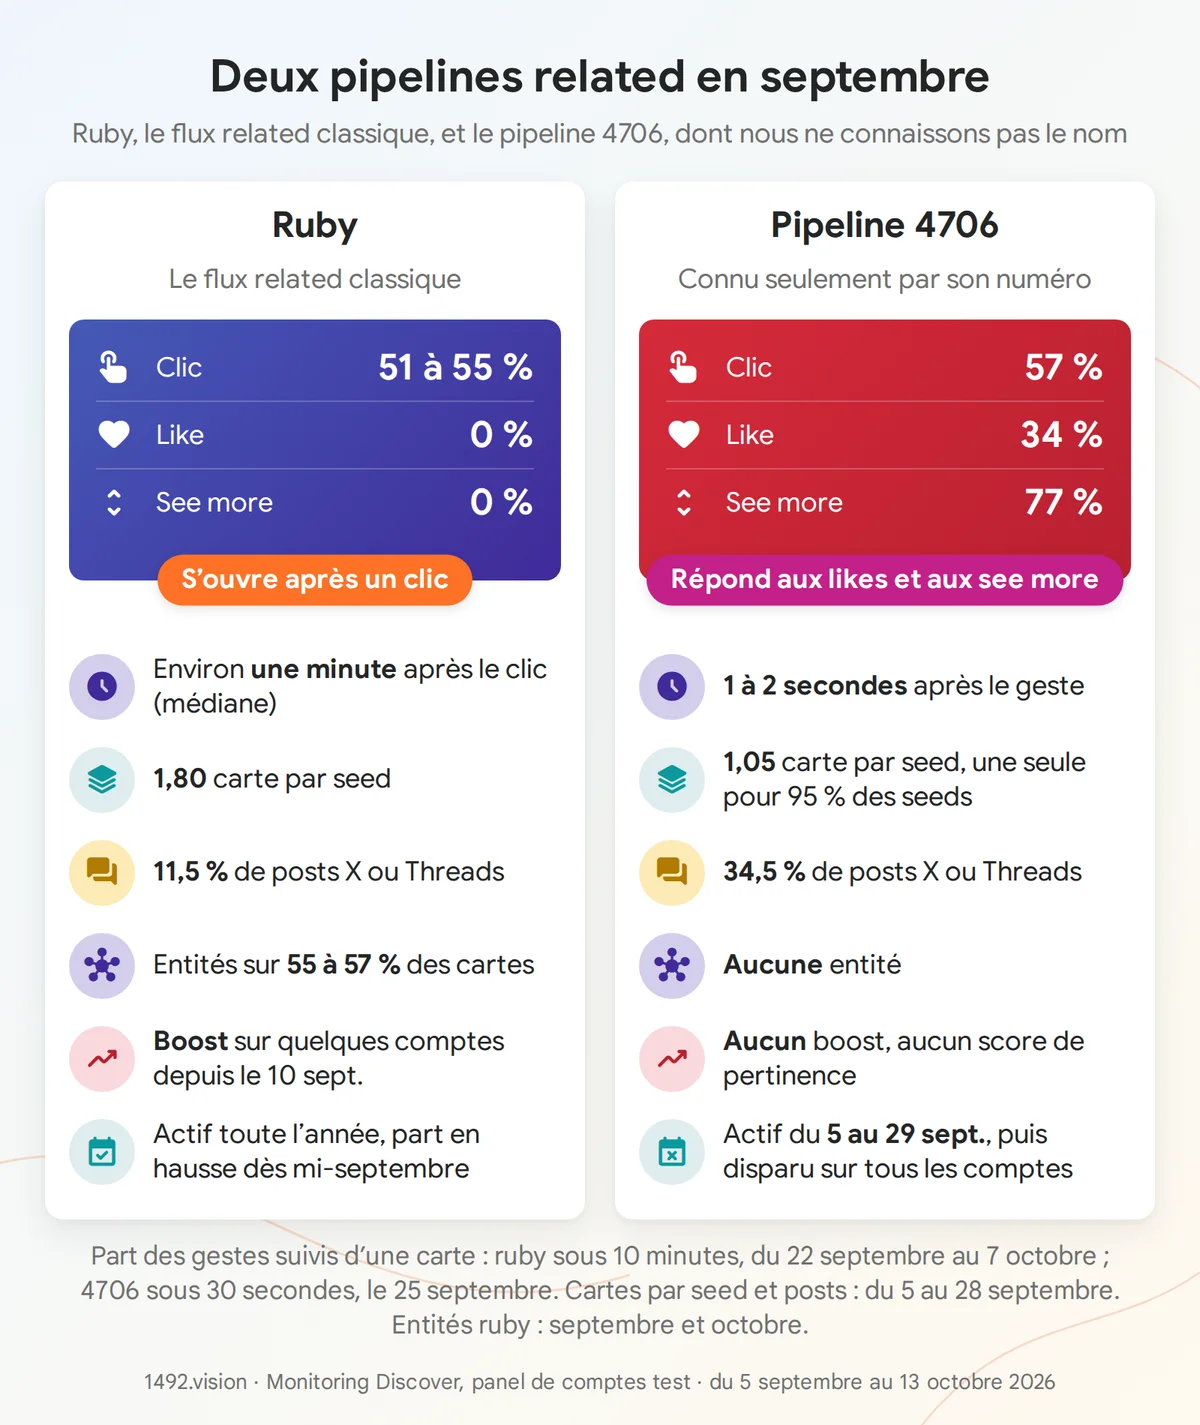
Ruby et le pipeline 4706 côte à côte. Les taux de ruby sont mesurés dans les 10 minutes (du 22 septembre au 7 octobre), ceux de 4706 dans les 30 secondes (25 septembre).
4.3 Conséquences pour les éditeurs dans le flux related
-
Le clic reste le geste qui ouvre ruby. Dans notre panel, un like ou un see more ne l'ouvre pas.
-
Pendant trois semaines, Google a fait fonctionner un pipeline related plus rapide et plus léger, qui répondait aux likes et aux see more et servait davantage de posts sociaux. S'il revient, les posts X et Threads pourraient prendre des places related qu'occupent aujourd'hui des articles.
-
Les cartes related sont désormais re-scorées pour certains lecteurs, et ce boost peut faire descendre comme monter.
5) f22.8 prédit désormais le mieux le clic
En décembre 2025, nous décrivions les « Multi-Objective Scores » : des scores de probabilité bruts attachés à chaque article, dont deux, le score 1 et le score 7, évoluaient en sens inverse. Ce sont f22.1 et f22.7 (corrélation de -0,91). L'ensemble s'est agrandi depuis. Le 30 juin, il est passé de sept à neuf scores avec f22.9 et f22.11, et f22.8 a perdu son plafond entre 0 et 1, avec une fenêtre de recalibrage du 30 juin au 3 juillet.
Un article de recherche de Google publié en juillet nomme Discover. Bai et al., « Heterogeneous Ranking in Industrial-Scale Recommender Systems: A Case Study » (RecSys '26, arXiv 2607.27577), décrit un tronc commun avec « 11 task-specific prediction heads », regroupées en engagements positifs (pInterest) et négatifs (pDisinterest). f22 ressemble à un tel ensemble de têtes, avec des positives et des négatives.
Nous avons mesuré, mois par mois, dans quelle mesure chaque score sépare les cartes cliquées des autres (AUC, où 0,5 correspond au hasard). Deux scores se détachent, f22.2 et f22.8, que nous lisons comme des prédicteurs d'engagement approfondi.
f22.8 est en tête depuis juillet, passant de 0,599 en juin à 0,619 en juillet, 0,651 en août et 0,690 en septembre. f22.2 était à égalité en mai (0,614 contre 0,619) et légèrement devant en juin (0,617), puis s'est maintenu entre 0,58 et 0,63. Début octobre est plus faible pour les deux (0,598 et 0,544, sur 749 clics).
Le meilleur prédicteur dépend aussi du compte. En mai et juin, f22.2 et f22.8 se partageaient la première place selon les comptes. En septembre, f22.8 était en tête sur 11 de nos 13 comptes.
f22.2 est le score f22 le plus lié au boost (corrélation de Spearman de +0,21). Sa médiane est tombée de 0,397 en avril à 0,087 en août, puis est remontée à 0,125 en septembre et 0,146 en octobre. Sa prédiction du clic n'a pas suivi (0,544 début octobre). Le score qui suit le mieux les clics et le score le plus lié au boost ne sont plus les mêmes.
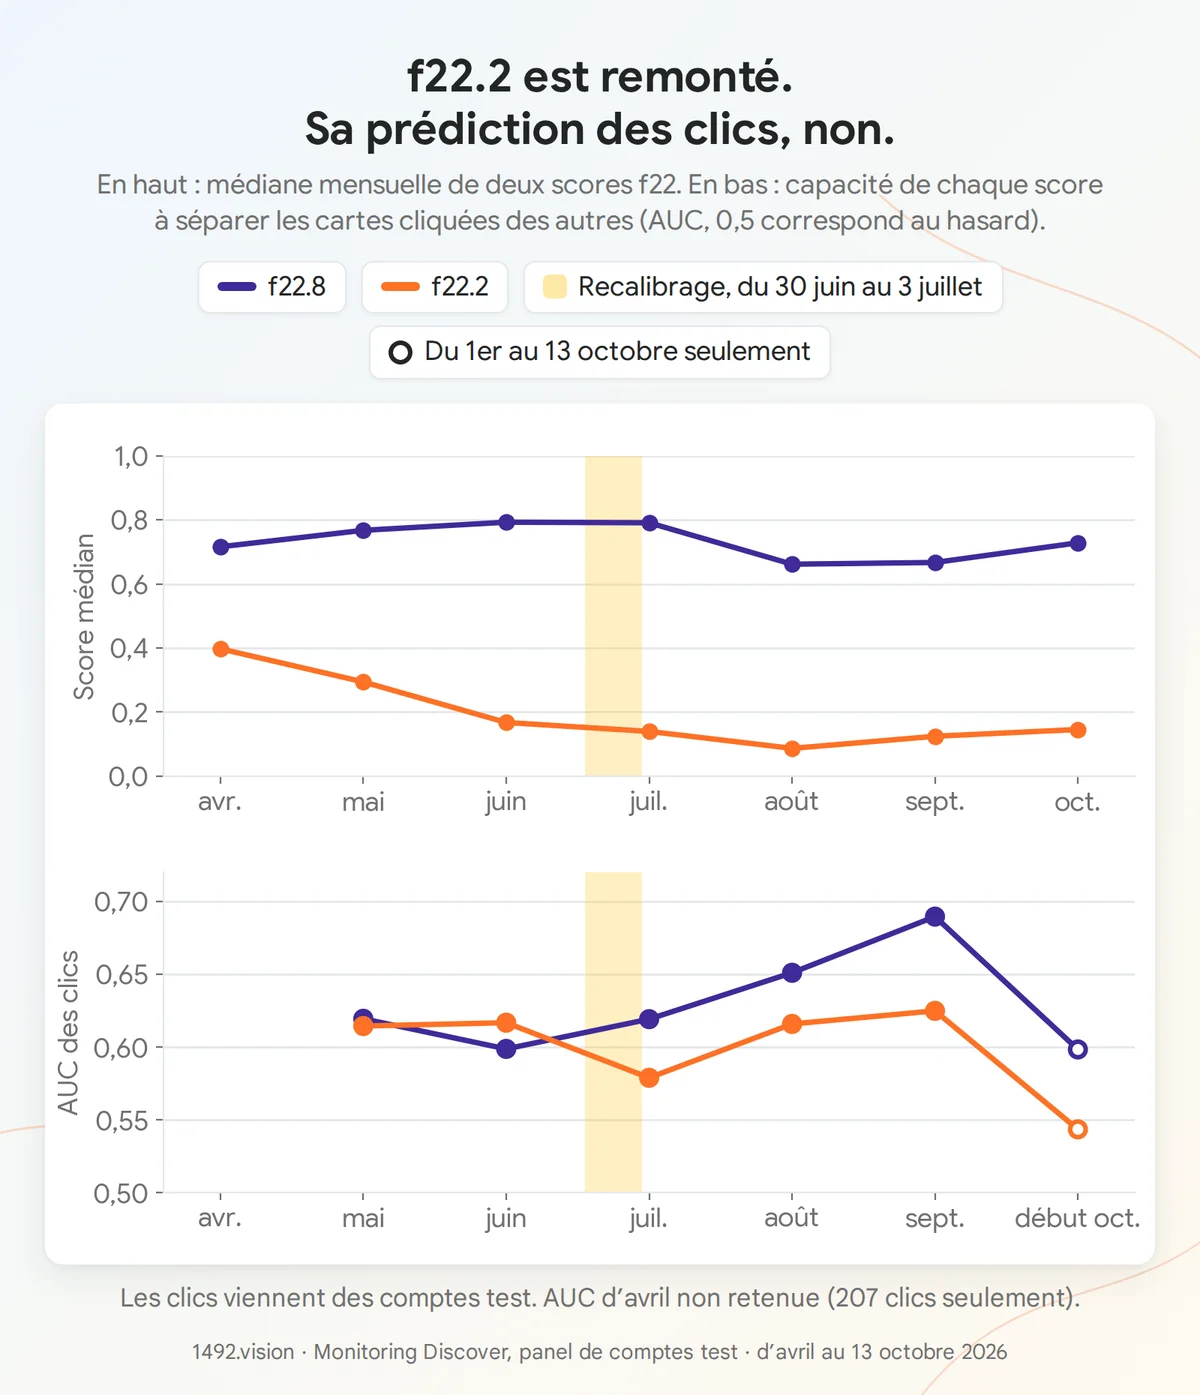
En haut : médiane mensuelle de f22.2 et f22.8. En bas : AUC de clic de chaque score. L'AUC d'avril est exclue (207 clics seulement).
6) Conséquences pour les éditeurs
Le champ 50 suggère que Discover choisit, pour chaque lecteur, une entité de l'article. Un article qui nomme clairement ses entités, le produit autant que l'entreprise, l'équipe autant que le sport, donne au système plus de facettes à rapprocher de plus de lecteurs.
L'historique de lecture semble compter davantage que les centres d'intérêt déclarés. Dans notre panel, le champ 50 suit ce que les comptes lisent (63 %) bien plus que ce qu'ils suivent explicitement (4 %). Les lecteurs que ce signal désigne sont ceux qui lisent déjà sur le sujet.
Le premier sujet du champ 47 est stable et, au niveau des verticales, proche de ce que renvoie la Natural Language API. Un angle clair aide ce premier sujet à être le bon ; les rangs 4 et 5 bougent de toute façon.
Dans le flux related, le clic reste le geste qui ouvre ruby, et certaines cartes related sont désormais boostées ou rétrogradées comme le reste du flux.
Sur f22, le clic suit f22.8 plus que f22.2 dans notre panel. Si f22.8 prédit la profondeur d'engagement, comme nous le lisons, ce score semble favoriser les articles qui gardent les lecteurs engagés après le clic.
Questions ouvertes
Le champ 50 agit-il dans la sélection des cartes, ou est-ce une étiquette conservée sur la carte ? Le pipeline 4706 reviendra-t-il, et avec quels déclencheurs ? Le champ 47 intervient-il dans le classement ? Notre monitoring continue sur ces trois points.
L'article est le même pour tous les lecteurs ; l'entité que Google lui associe change d'un lecteur à l'autre.
Méthode et limites
Cet article s'appuie sur le monitoring Discover de 1492.vision : un panel de comptes test, en anglais et en français, suivi du 1er mars au 15 octobre 2026. Pour chaque carte, nous regardons les signaux qui y sont attachés, le pipeline qui l'a amenée, et ce qui se passe après un clic, un like ou un see more.
-
Noms et numéros : Google ne publie aucune numérotation de ces signaux. « Champ 50 », « champ 47 », « f22.8 » sont les étiquettes que nous avons données à chacun pour le suivre ; le numéro est notre index. Les scores f22 et les champs f42/f43 sont des scores de classement et de prédiction que le système calcule pour chaque carte ; les champs 47, 48 et 50 sont d'autres signaux par carte (les sujets, la source, l'entité). Le sens que nous leur donnons est notre interprétation. Les chaînes comme relatedcontentruby ou DISCOVER_PERSONALIZED_ENTITY_SEMANTICS sont des noms internes de Google, cités tels quels.
-
Panel : les clics, likes et see more viennent de nos comptes test. Les parts et les AUC de f22 décrivent ce panel ; de vrais lecteurs à grande échelle peuvent se comporter autrement.
-
Champ 50 : nous ne lui voyons aucun effet sur le classement, et le nom interne ne prouve pas que le champ 50 en soit la sortie. Le lien est une hypothèse fondée sur le vocabulaire et le calendrier.
-
f42 et f43 marquaient des tests sur un seul compte.
-
La rotation du champ 47 suit le temps plus que le lecteur.
-
L'arrêt du pipeline 4706 le 29 septembre ne permet pas de savoir s'il reviendra.
Notes
-
MID : identifiant machine du Knowledge Graph. Les identifiants /m/ viennent de l'ancienne base Freebase, les identifiants /g/ sont plus récents.
-
Route, pipeline : le circuit de sélection qui a amené une carte dans le flux (flux principal, vidéos fraîches, related...). Certains ont des noms internes, comme relatedcontentruby ou paginationpanoptic (le flux principal) ; 4706 n'est connu que par son numéro.
-
UGC, AIGC : UGC est la route des contenus créés par les utilisateurs (posts et vidéos des plateformes). AIGC est la route des cartes AI Overview.
-
Aura : une route de recommandation large et généraliste, très liée au flux principal, qui reprend des articles déjà vus par le lecteur ou par des profils proches.
-
Vidéos fraîches : la route qui sert des vidéos publiées récemment.
-
Star search : la route qui sert des cartes liées aux recherches que le lecteur a faites ou enregistrées.
-
Filtrage collaboratif : la route qui recommande ce qu'ont cliqué des lecteurs au comportement proche, plutôt que ce qui correspond au sujet de l'article.
-
Retrieval : l'étape qui sélectionne les cartes candidates avant leur classement.
-
Seed : l'article ou la carte avec lequel le lecteur a interagi, et dont part un pipeline related.
-
See more : le bouton qui déplie le résumé d'une carte sur place, sans ouvrir l'article.
-
Boost : une valeur d'ajustement de classement attachée à certaines cartes. Depuis le 10 septembre, certaines cartes related en portent une, positive ou négative.
-
Verticale : le premier niveau de la taxonomie de sujets de Google (News, Sports, Arts & Entertainment...).
-
Multi-label : une carte peut appartenir à plusieurs verticales à la fois.
-
Similarité de Jaccard : le recouvrement de deux ensembles, éléments communs divisés par l'ensemble des éléments distincts.
-
AUC : la probabilité qu'un score classe une carte cliquée au-dessus d'une carte non cliquée. 0,5 correspond au hasard, 1 à un prédicteur parfait.
-
Corrélation de Spearman : une corrélation calculée sur les rangs, de -1 à +1.
Source
- Damien Andell, Inside Google Discover's 2026 Card Signals: One Entity per Reader, Rotating Topics and a Related Feed That Answered Likes, LinkedIn, 15 octobre 2026. Première publication de cet article, en anglais.
Authors
Posted on 2026-10-15
Plus d'infos fiables et sourcées sur Discover ? Ajoutez-nous aux sources !
Ajouter aux sources Ajouter aux sources