Les plateformes font lire vos articles par un LLM mais laissent vos lecteurs décider du classement
CIKM 2026, la conférence de l'ACM sur la gestion de l'information et des connaissances, s'est tenue à Rome du 7 au 11 novembre. Sa piste de recherche appliquée porte sur des systèmes en production : Google, LinkedIn, Meta et ByteDance y décrivent comment ils recommandent et classent les contenus. Nous avons lu huit papiers, sept de CIKM et un de RecSys 2026, et nous les avons confrontés à nos données Discover. Cet article les reprend plateforme par plateforme, puis présente notre mesure sur les titres racoleurs, avec sa méthode complète.
En bref
- Le LLM lit mais le classement apprend surtout des lecteurs. Google fait comparer des paires d'articles par un grand modèle de langage (LLM). Meta lui fait parcourir le réseau d'un utilisateur, ByteDance lui fait lire le titre et la parole des vidéos. Le classement, lui, est entraîné sur les clics, le temps passé, les « j'aime », les partages et les rejets.
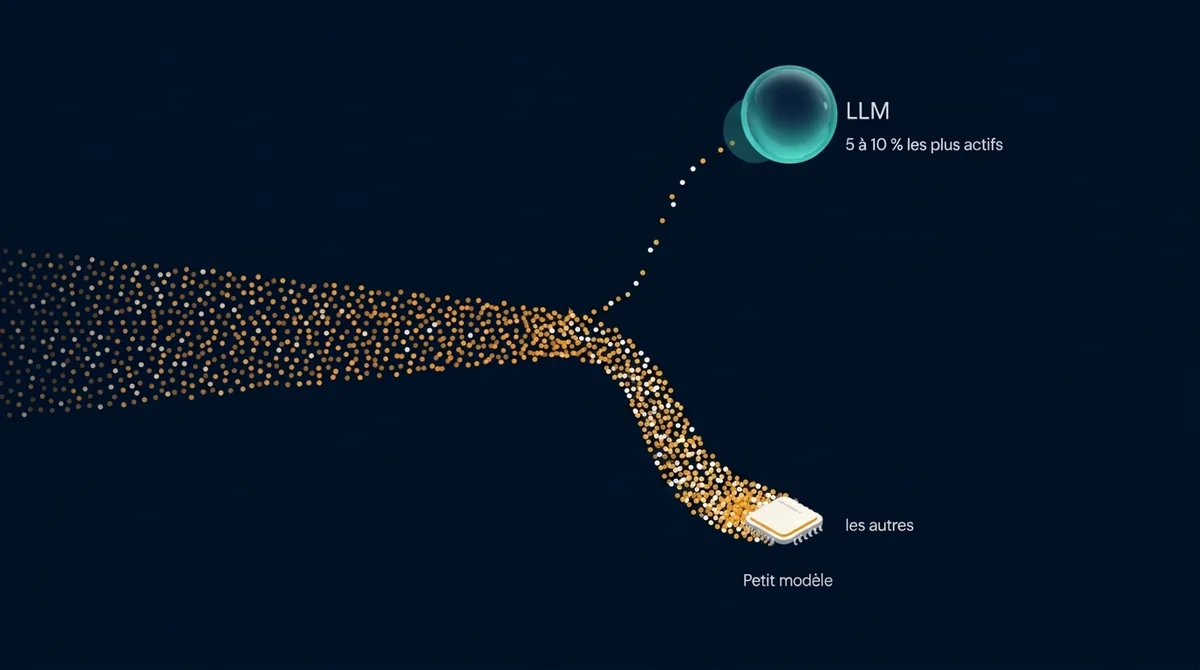
- Le LLM demande beaucoup de calcul. Google, et LinkedIn pour sa recherche d'emplois, le font imiter par un petit modèle, qui tourne en production. Meta le réserve aux 5 à 10 % d'utilisateurs les plus actifs.
- LinkedIn a testé un classement du fil par LLM. En ligne, il n'a jamais battu le modèle en place.
- Chez Baidu, le partage dépend de la requête. Les étiquettes d'un LLM font mieux que les clics sur les requêtes rares. Sur les requêtes fréquentes, les clics gardent un léger avantage : ils captent l'autorité et la qualité de la page.
- Le lien entre lecteur et source entre à part. LinkedIn l'ajoute au modèle comme une information séparée. Discover réserve une file aux sources que le lecteur suit.
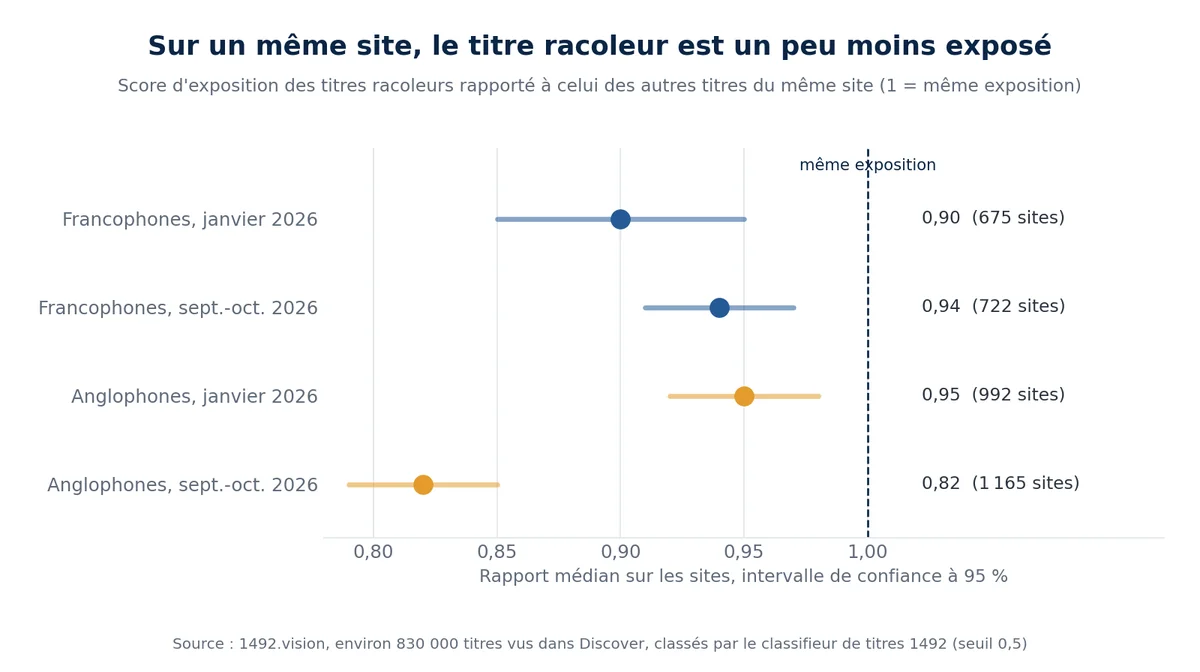
- Dans nos données Discover, à site égal, le titre racoleur est un peu moins exposé. Le rapport va de 0,90 à 0,95, sauf dans les fils anglophones de septembre-octobre, où il descend à 0,82.
Lire, puis classer
Un système de recommandation travaille par étapes. Il réunit des candidats (articles, posts, vidéos), en écarte une partie avec des filtres, puis classe ceux qui restent pour chaque utilisateur. Dans les papiers de CIKM 2026, le LLM intervient avant le classement ou à côté. Il lit un contenu, ou le réseau d'un utilisateur, et en tire une étiquette ou une description. Le classement final, lui, revient plutôt à un modèle qui prédit les réactions du lecteur.
Trois termes reviennent dans la suite :
- étiqueter : un grand modèle juge des exemples, comme deux articles sur le même sujet ou une offre d'emploi face à une requête, et ses jugements servent à entraîner un autre modèle ;
- le petit modèle qui imite : entraîné sur ces étiquettes, il tourne en production, plus vite et avec moins de calcul ;
- le test A/B : une partie des utilisateurs reçoit le nouveau système, l'autre garde l'ancien, et les gains publiés comparent les deux groupes.
Ces recherches appliquées répondent à une question que les rédactions se posent depuis que les LLM sont partout : faut-il écrire pour eux ? Si l'on en croit ces papiers, présentés par les chercheurs des plateformes dans une piste consacrée aux systèmes en production, la réponse est nette :
Le LLM lit vos articles, mais le rang se décide sur les réactions de vos lecteurs.
Discover : deux filtres avant le classement
Nous avons analysé le papier SDF de Google dans notre article sur la péremption dans Discover. Avant de classer, Discover retire les articles périmés. Deux filtres s'en chargent.
Le premier repère un article dépassé par un article plus récent sur le même sujet. Google a fait étiqueter 1,1 million de paires d'articles par un grand modèle, PaLM 2-L. Puis il a entraîné un modèle plus petit, T5 (11 milliards de paramètres), à reproduire ces étiquettes. On retrouvera cette recette chez LinkedIn et chez Meta : le grand modèle étiquette, le petit modèle sert.
Le second filtre, appelé PTR, estime si un article a déjà reçu l'essentiel de son audience. Il lit le texte, les images et la vidéo. Mais il apprend sur les clics venus de la recherche Google. Google n'utilise pas les pages vues, qu'il juge faussées par la promotion des éditeurs (« biased by publisher promotion »).
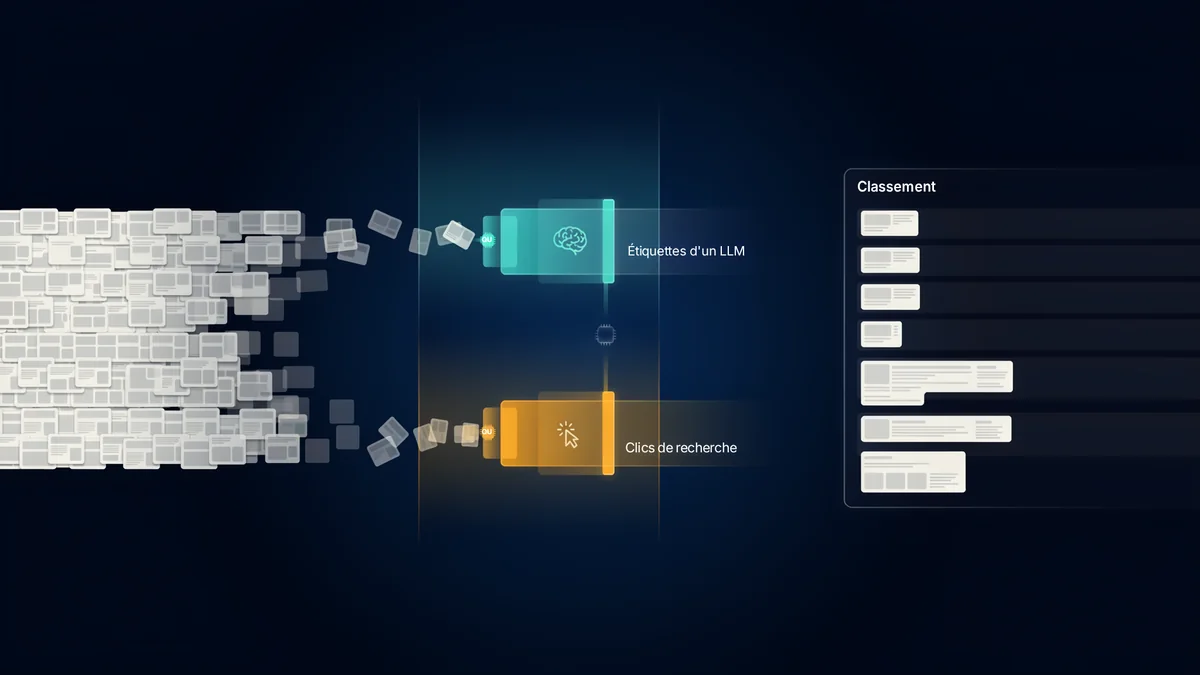
Vient ensuite le classement. Un autre papier de la même équipe, présenté à RecSys 2026, le décrit. Le modèle prédit 11 réactions du lecteur : des réactions positives (clic, « j'aime ») et négatives (rejet de la carte, blocage d'une source). Le papier ne donne ni la liste complète ni le poids de chacune.
Les auteurs nomment un risque : un modèle réglé d'abord sur le taux de clic « may disproportionately favor low-quality articles (e.g., click-bait) over high-value videos and UGC ». Dans leur modèle de base, de mauvais articles passaient souvent devant de bonnes vidéos (« poor-quality web articles frequently outranked high-quality videos »). Nous mesurons plus bas la place des titres racoleurs dans nos fils.
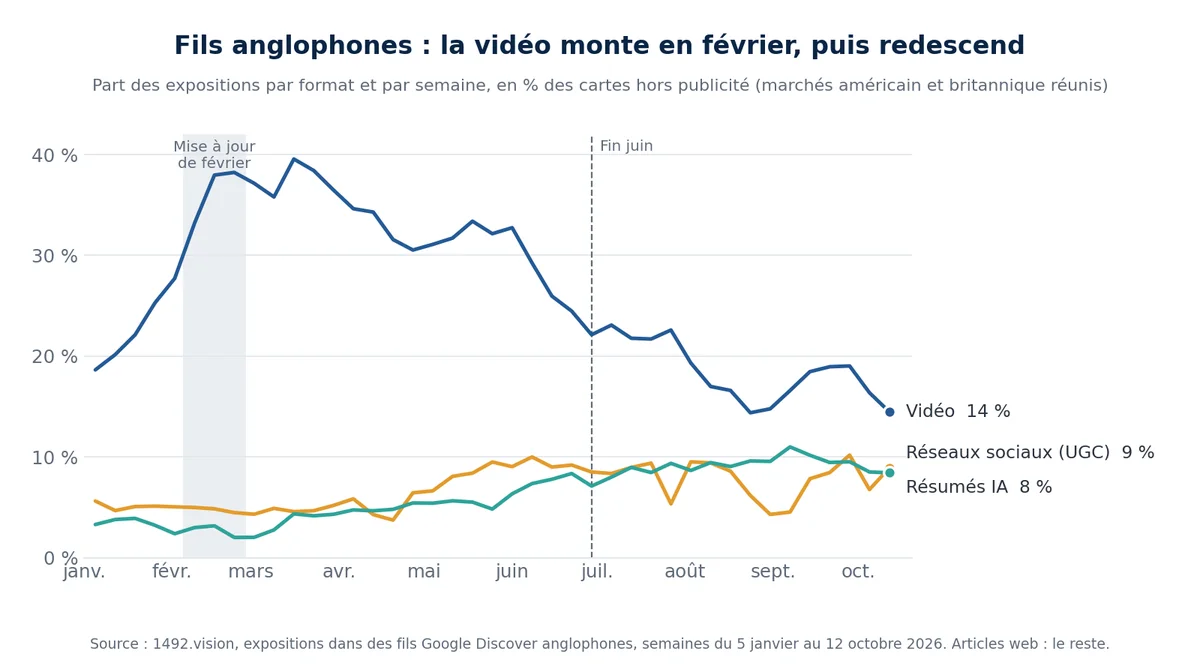
Le papier précise aussi que les formats n'appellent pas les mêmes réactions : « articles primarily drive clicks, whereas UGC and sports match cards drive long dwell time ». Et pour les formats nouveaux, comme les résumés générés par IA, le modèle peut s'appuyer sur le contenu de la carte plutôt que sur un historique de réactions encore maigre (« transitioning away from sparse historical interaction signals to focus on the rich semantics within the card »). On retrouve la règle de Baidu : le texte compte quand les réactions manquent. Dans nos fils, les formats autres que l'article web n'ont pas gagné de place après juin 2026. En anglais, la vidéo recule, et seuls les résumés générés par IA progressent.
LinkedIn : le classement par LLM a échoué en ligne
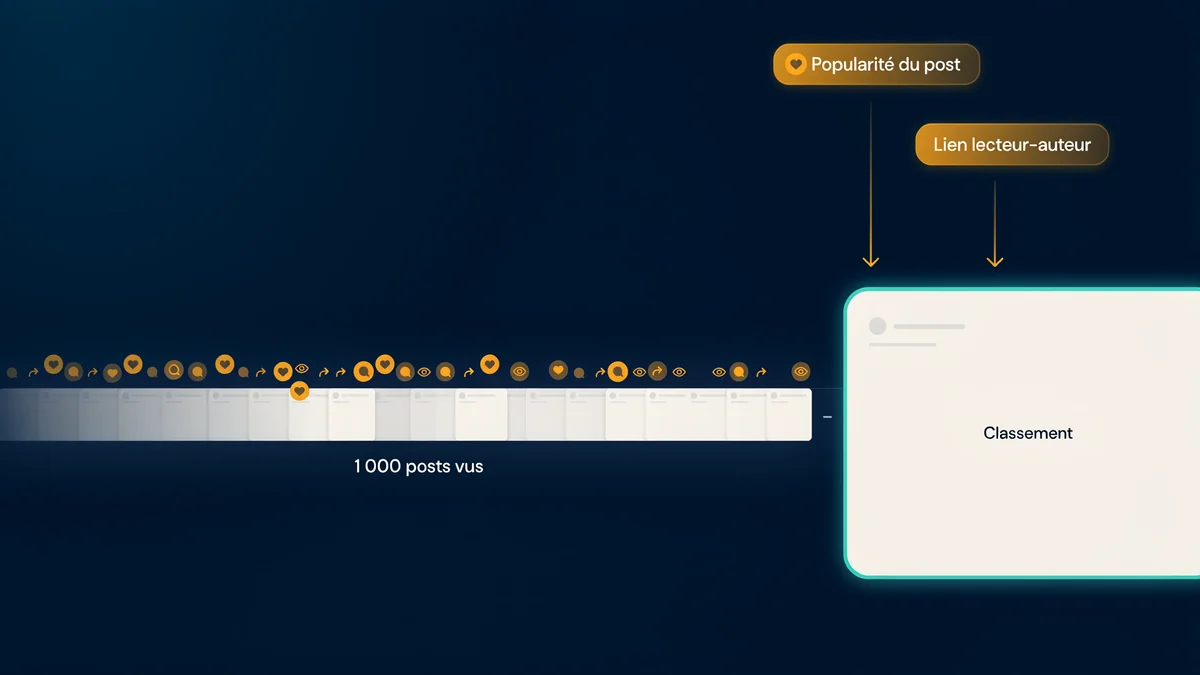
Le fil LinkedIn est classé par un modèle qui prédit, pour chaque post, si vous allez le lire longtemps, cliquer, aimer, commenter ou partager. Pour cela, il regarde vos 1 000 derniers posts vus et ce que vous en avez fait. En test A/B, il a fait gagner 2,10 % de temps passé et 3,52 % de réactions.
Deux informations entrent à part : la popularité du post, et le lien entre vous et son auteur.
L'équipe a aussi testé un classement construit sur un LLM. Il marchait bien sur les posts de personnes que vous ne suivez pas. Il peinait sur ceux de votre réseau. Et il demandait beaucoup de calcul. En ligne, il n'a jamais battu le modèle en place : « the LLM-Ranker never achieved superior online performance over the existing production model ».
Notre lecture :
Le lien entre vous et l'auteur ne figure pas dans le texte du post. Un modèle qui lit le texte seul ne peut pas le deviner.
LinkedIn se sert quand même d'un LLM, dans la recherche d'emplois. Un modèle de 8 milliards de paramètres juge la pertinence des offres. Un modèle de 0,6 milliard apprend à l'imiter, et c'est lui qui tourne en production. On retrouve la recette de Google.
Baidu : les clics apprennent ce que le texte ne dit pas
Une équipe de l'Académie chinoise des sciences, avec trois chercheurs de Baidu, pose la question directement. Un moteur de recherche peut-il apprendre sur des étiquettes posées par un LLM, plutôt que sur les clics des internautes ?
Leur réponse dépend des requêtes :
- sur les requêtes rares, le LLM fait mieux que les clics ;
- sur les requêtes fréquentes, les clics gardent un léger avantage ;
- mélanger les deux signaux donne le meilleur résultat.
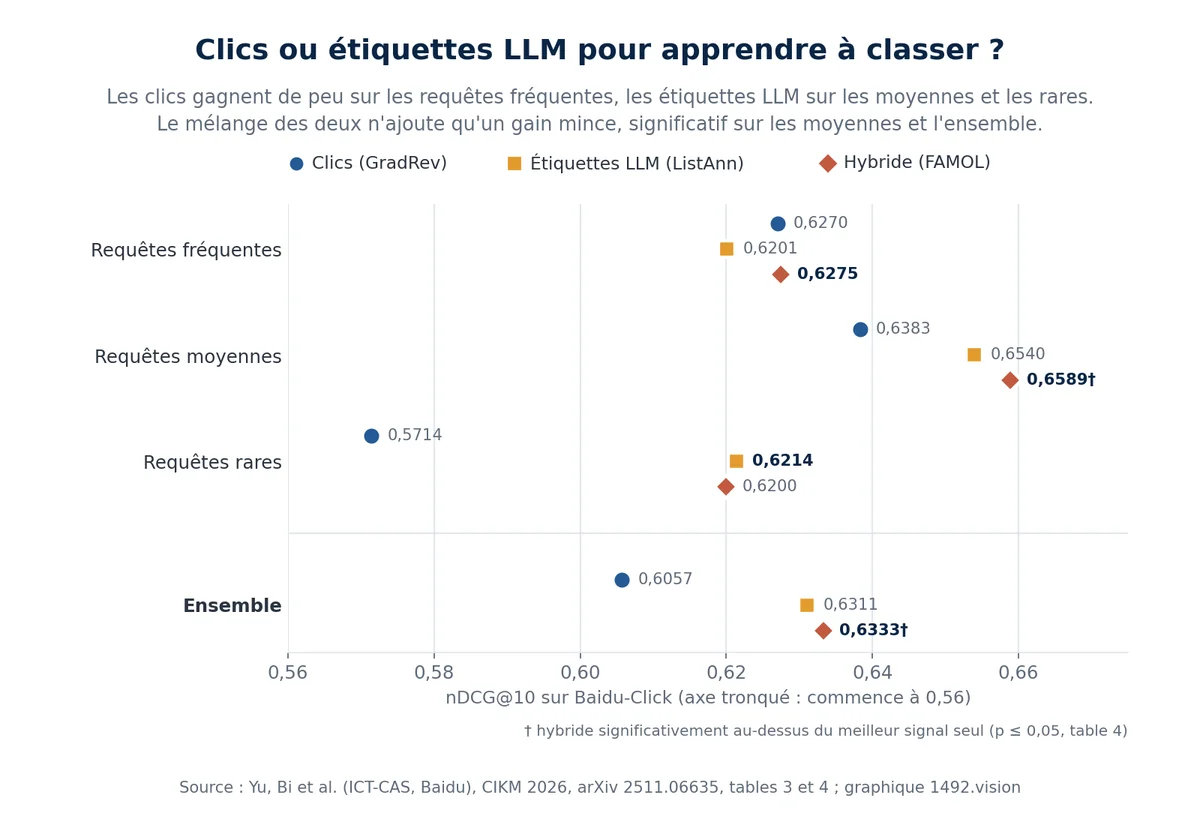
L'écart vient du volume de clics. Sur une requête fréquente, beaucoup de pages répondent bien. Les clics de milliers d'internautes permettent de les départager : selon les auteurs, ils captent l'autorité et la qualité de la page, que le LLM ne voit pas dans le texte. Sur une requête rare, celles de la longue traîne, les clics sont trop peu nombreux ou trop bruités pour apprendre (« sparse or unreliable »). Le LLM, lui, n'a besoin que du texte : il juge si la page répond à la requête, même si peu d'internautes l'ont vue.
Les chercheurs ont essayé de donner au LLM le PageRank de chaque page, pour combler son retard sur les requêtes fréquentes. Sans succès : le modèle lit mal les nombres.
Les SEO penseront à NavBoost. Au procès antitrust de Google aux États-Unis, en 2023, Pandu Nayak, responsable de la recherche chez Google, l'a décrit comme une mémoire des clics sur les résultats, sur les 13 derniers mois (SE Ranking reproduit l'extrait de son témoignage). Un ancien ingénieur de Google, Eric Lehman, l'a résumé ainsi : « juste une grande table » (Abondance). La fuite de la documentation interne de Google, en 2024, a détaillé les types de clics enregistrés (Resoneo).
Une mémoire de clics ne sert que là où les clics existent, donc surtout sur les requêtes fréquentes. Le papier ne parle pas de Google, et le rapprochement est le nôtre. Mais la lecture est la même :
Les clics là où il y a du volume, un modèle de langage pour la longue traîne.
Transposé à un flux, on peut penser que les réactions des lecteurs, quand ils sont nombreux, apprennent au système ce que le texte ne dit pas.
Meta et ByteDance : réserver le LLM ou l'entraîner sur l'usage
Chez Meta, un LLM parcourt le réseau d'un utilisateur (amis, groupes, pages suivies) pour lui trouver des vidéos. En test A/B, le temps de visionnage gagne 0,43 %. Mais le LLM ne sert que les 5 à 10 % d'utilisateurs les plus actifs. Pour les autres, un petit modèle imite ses choix, en une milliseconde environ.
Chez ByteDance, le papier porte sur la recherche dans Douyin, la version chinoise de TikTok. Un modèle lit le titre, le texte affiché et la parole des vidéos. Il apprend en même temps que le classement, sur le comportement des utilisateurs. Il classe mieux qu'un modèle de langue générique laissé tel quel. En ligne, il fait gagner 0,56 % de temps passé et de 1,1 à 1,5 % de réactions (vidéos regardées jusqu'au bout, « j'aime », partages).
Ces gains sont petits. ByteDance précise qu'un gain de 0,1 % sur ses tests hors ligne suffit à produire des gains visibles en test A/B.
Le même partage chez les quatre
| Plateforme | Le LLM lit | Le classement apprend sur |
|---|---|---|
| Google Discover | Des paires d'articles, pour repérer les articles dépassés | Les clics de recherche (âge de l'article) ; 11 réactions du lecteur (classement) |
| LinkedIn (fil) | Rien : le classement par LLM a été abandonné | Lecture longue, clic, « j'aime », commentaire, partage, sur 1 000 posts vus |
| Meta | Le réseau des 5 à 10 % d'utilisateurs les plus actifs | Le temps de visionnage |
| ByteDance (recherche Douyin) | Le titre, le texte affiché et la parole des vidéos | Le comportement de recherche |
Le LLM demande beaucoup de calcul. Les plateformes le réservent donc aux utilisateurs les plus actifs, ou entraînent un petit modèle à l'imiter.
Le classement garde ce que le texte ne contient pas : l'autorité d'une source, le lien entre un lecteur et un auteur, la popularité d'un post.
Dans nos données Discover
Nous suivons des fils Discover réels, en français et en anglais. Discover associe à chaque carte des scores internes. Nous en décrivons certains depuis décembre 2025 (nos premiers relevés), puis dans notre étude sur la prédiction d'attention.
Comme les 11 réactions du papier RecSys, ces scores vont par familles. Certains montent avec l'engagement prédit. D'autres estiment un désintérêt, par exemple le risque que la carte soit dépassée sans un regard.
Notre article SDF en donnait deux exemples. Le score que nous appelons « potentiel de sujet » dépend du contenu et presque pas du lecteur. Quand un même fil revoit un même article, ce score ne change pas avec l'âge de l'article (environ 11 500 cas). Et il traite à l'identique les articles dont l'adresse contient une formule racoleuse : 0,187 contre 0,183, sur environ 23 500 articles, au printemps 2026.
Discover réserve aussi une place aux sources que le lecteur suit. Leurs articles passent par une file de recommandation à part, followedcreatorcontent, qui fonctionne comme un emplacement réservé, avec un poids moyen environ deux fois plus élevé. Et quand le lecteur suit une source, la part de l'affinité entre ce lecteur et cette source monte d'environ 18 % dans la prédiction (notre newsletter d'octobre 2026). C'est l'équivalent du lien lecteur-auteur que LinkedIn traite à part. Le papier RecSys décrit le même mécanisme côté Google : pour un créateur suivi, le modèle peut délaisser la popularité générale, qui domine le classement des contenus non suivis, au profit de l'affinité entre le lecteur et le créateur (« away from the global popularity priors that heavily influence unfollowed organic ranking, orienting instead toward user-creator affinity »).
Les titres racoleurs sont un peu moins diffusés
Un autre papier de CIKM 2026 propose une nouvelle méthode pour détecter les titres racoleurs. Puisqu'il ne dit rien de leur diffusion, nous avons fait la mesure.
Nous avons classé environ 830 000 titres vus dans Discover, en français et en anglais, avec un classifieur de titres 1492, entraîné pour mesurer les titres plus ou moins racoleurs. Les titres viennent de deux périodes : janvier 2026, puis septembre et octobre 2026. Pour chaque site, nous avons comparé le score d'exposition de ses titres racoleurs à celui de ses autres titres.
Sur un même site, un titre racoleur est un peu moins exposé.
| Janvier 2026 | Septembre-octobre 2026 | |
|---|---|---|
| Fils francophones | 0,90 | 0,94 |
| Fils anglophones | 0,95 | 0,82 |
Exposition des titres racoleurs rapportée à celle des autres titres du même site (1 = même exposition). Médiane sur 675 à 1 165 sites selon la case. Tous les intervalles de confiance à 95 % restent sous 1.
L'écart grandit quand on ne garde que les titres les plus nettement racoleurs. En anglais, il était faible au printemps et s'est nettement creusé à l'automne. Le détail de la mesure est en fin d'article.
À l'entrée, le potentiel de sujet ne pénalise pas les formules racoleuses. L'écart se formerait donc ensuite, quand le classement apprend sur les réactions des lecteurs, rejets et cartes ignorées compris.
Pour les éditeurs
Les papiers présentés lors de cette conférence technique ne donnent aucun conseil aux éditeurs. Les pistes suivantes sont donc nos déductions.
- Écrire pour le lecteur. Des modèles lisent votre texte, mais le classement apprend sur ce que le lecteur en fait : lire longtemps, partager, rejeter la carte.
- Dire ce que l'article apporte. Le juge de Google compare votre article aux plus récents. L'encodeur de ByteDance lit le titre. Un titre qui donne l'information se lit mieux qu'une formule vague. Dans nos données, à site égal, le titre racoleur est d'ailleurs un peu moins exposé.
- Soigner le lien avec vos lecteurs. LinkedIn traite à part le lien entre lecteur et auteur. Meta parcourt le réseau de l'utilisateur. Discover réserve une place aux sources suivies. Inviter vos lecteurs à suivre votre source joue sur un signal que le texte ne porte pas.
- Ne pas compter sur la promotion maison. PTR apprend sur les clics de recherche. Votre page d'accueil, vos notifications et vos réseaux sociaux ne rendent pas un article plus durable à ses yeux.
- Garder vos lecteurs fidèles. Chez LinkedIn, les membres les plus actifs gagnent le plus avec le nouveau modèle. Chez Meta, le LLM ne sert que les 5 à 10 % les plus actifs. Les systèmes connaissent mieux les lecteurs réguliers.
La mesure en détail
Les titres. Environ 830 000 articles vus dans nos fils Discover, en français et en anglais, sur deux périodes : janvier 2026, puis septembre et octobre 2026. Nous gardons les sites d'au moins 20 articles, avec au plus 200 articles par site, langue et période, tirés au sort. Les réseaux sociaux et les vidéos sont exclus. Nous retirons aussi les titres qui n'en sont pas : des textes d'interface captés à la place du titre (3 760 articles) et des titres répétés à l'identique sur un même site, comme un nom de rubrique ou un résultat de course hippique (1 486 articles). Les titres repris à l'identique par plusieurs sites restent : ce sont de vrais articles.
L'étiquette. Le classifieur de titres de 1492 donne à chaque titre une probabilité d'être racoleur. Il ne lit que le titre. Au-dessus de 0,5, le titre compte comme racoleur. Au-dessus de 0,8, il est nettement racoleur. Sur 600 titres jugés par un LLM, le classifieur retrouve les titres racoleurs avec un F1 de 0,79 (macro-F1).
Le calcul. Dans chaque site, nous comparons le score d'exposition médian de ses titres racoleurs à celui de ses autres titres, tirés en nombre égal (200 tirages). Un site compte s'il a au moins 3 titres racoleurs. Le chiffre retenu est la médiane de ces rapports sur les sites. L'intervalle à 95 % vient de 2 000 tirages au hasard parmi les sites.
Au seuil strict. L'écart grandit dans les quatre cases. Les titres classés racoleurs de justesse n'expliquent donc pas le résultat.
| Seuil 0,5 | Seuil 0,8 | |
|---|---|---|
| Fils francophones, janvier | 0,90 [0,85 ; 0,95] | 0,88 [0,78 ; 0,92] |
| Fils francophones, septembre-octobre | 0,94 [0,91 ; 0,97] | 0,88 [0,79 ; 0,95] |
| Fils anglophones, janvier | 0,95 [0,92 ; 0,98] | 0,93 [0,90 ; 0,97] |
| Fils anglophones, septembre-octobre | 0,82 [0,79 ; 0,85] | 0,79 [0,74 ; 0,82] |
Entre crochets, l'intervalle de confiance à 95 %. De 675 à 1 165 sites selon la case.
Une seconde mesure. Nous avons aussi calculé, dans chaque site, la probabilité qu'un titre racoleur tiré au hasard soit plus exposé qu'un autre titre du même site. Sans écart, elle vaudrait 0,5. Elle est sous 0,5 dans les quatre cases : de 0,47 à 0,49 en janvier et en français, 0,43 en anglais en septembre-octobre. Cette mesure ne dépend pas de la forme du score, et elle confirme l'écart.
Dans le temps, en anglais. Google a annoncé sa mise à jour Discover de février 2026 comme visant notamment le sensationnalisme et le clickbait (annonce de Google). Elle a été déployée du 5 au 27 février, d'abord aux États-Unis. Nous avons classé deux tranches de plus en anglais et comparé l'écart à celui de janvier, sur les mêmes sites :
| Comparé à janvier | Sites | Évolution de l'écart |
|---|---|---|
| 28 février au 6 mars | 354 | 1,05 [0,95 ; 1,12] |
| 7 mars au 30 avril | 784 | 0,96 [0,93 ; 1,00] |
| Septembre-octobre | 653 | 0,83 [0,76 ; 0,85] |
1 = écart inchangé ; sous 1, l'écart se creuse au détriment des titres racoleurs.
Juste après le déploiement, l'écart ne bouge pas. Il se creuse un peu au printemps, sur une période qui couvre aussi la mise à jour principale de mars, puis nettement à l'automne. Entre-temps, Discover a connu d'autres changements, au début de juillet notamment. La mesure ne rattache donc pas l'écart à la mise à jour de février. En français, la mise à jour n'était pas annoncée en février : nous n'avons pas fait ce test.
Par rubrique. L'écart le plus régulier porte sur le sport et la vie pratique, dans les deux langues. Aucune rubrique ne favorise nettement les titres racoleurs. Le classifieur déduit la rubrique du seul titre : ce découpage est indicatif.
Les autres indicateurs. Le pic d'exposition journalier départage mal les articles peu vus : le rapport y vaut souvent 1. La plupart des articles ne sont vus qu'un jour. La part d'articles vus au moins deux jours est plus faible chez les titres racoleurs anglais en septembre-octobre (8 points de moins), mais cet indicateur est moins solide que le score.
Le texte compte, parce que des modèles le lisent. Mais le lecteur compte encore davantage, parce que le classement apprend de lui.
Les manettes sont là, à vous de jouer !
Sources
- Di Bai, Feng Han, Zhenwei Tang, Jintao Liu, Luoshu Wang, Jialu Liu. « Decomposing Staleness in Recommender Systems: A Dual-Filter Framework for Supersession and Decay ». CIKM 2026. arXiv 2608.15780, DOI 10.1145/3799682.3840082.
- Di Bai, Jintao Liu, Zhenwei Tang, Peifan Wu, Nada Al-Thawr, Luoshu Wang. « Heterogeneous Ranking in Industrial-Scale Recommender Systems: A Case Study ». RecSys 2026. arXiv 2607.27577, DOI 10.1145/3773078.3831848.
- Lars Hertel, Gaurav Srivastava et al. « An Industrial-Scale Sequential Recommender for LinkedIn Feed Ranking ». CIKM 2026. arXiv 2602.12354, DOI 10.1145/3799682.3840102.
- Fedor Borisyuk et al. « Semantic Search At LinkedIn ». CIKM 2026. arXiv 2602.07309, DOI 10.1145/3799682.3840152.
- Lulu Yu, Keping Bi, Jiafeng Guo, Shihao Liu, Shuaiqiang Wang, Dawei Yin, Xueqi Cheng. « Can LLM Annotations Replace User Clicks for Learning to Rank? ». CIKM 2026. arXiv 2511.06635, DOI 10.1145/3799682.3841034.
- Haoyu Han, Yuming Liu, Lei Huang, Lizhu Zhang, Jiliang Tang, Xiangjun Fan. « ConnectionMind: Leveraging Social Networks and Large Language Models for Personalized Recommendation at Meta ». CIKM 2026. arXiv 2608.10187, DOI 10.1145/3799682.3840157.
- Xintian Han, Honggang Chen, Quan Lin et al. « LEMUR: Large scale End-to-end MUltimodal Recommendation ». CIKM 2026. arXiv 2511.10962, DOI 10.1145/3799682.3840084.
- Changrong Min et al. « Two important things you must know! Revisiting Clickbait Detection from Perspectives of Humans' Cognition and Emotion ». CIKM 2026. DOI 10.1145/3799682.3840795.
- Google Search Central, Google's February 2026 Discover Core Update, 5 février 2026.
- SE Ranking, NavBoost, avec l'extrait du témoignage de Pandu Nayak (procès DOJ contre Google, 2023).
- Resoneo, Google leak part 5: click data, NavBoost, Glue and beyond.
- Abondance, NavBoost, signaux manuels, pogosticking : la face cachée du ranking Google.
- 1492.vision, L'été des Search Profiles, newsletter d'octobre 2026.
- 1492.vision, Google Discover trie le périmé avant de classer : le papier SDF face à nos données.
- 1492.vision, Deep dive : comment Discover prédit votre attention.
- 1492.vision, Inside Google Discover's New Internal Signals, LinkedIn, décembre 2025.
Authors
Posted on 2026-11-11
Plus d'infos fiables et sourcées sur Discover ? Ajoutez-nous aux sources !
Ajouter aux sources Ajouter aux sources